2026-10-29 정정 — 출처가 확인되지 않은 이탈·매출 수치를 철회했습니다. A/B 숫자는 실제 수행한 실험이 아닌 가상 예시로 표시했습니다.
"왜 갑자기 영상이 멈추지?"
치지직 보다가 동그라미 빙빙 도는 거 본 적 한 번도 없는 사람은 없을 거다. 근데 정확히 왜 멈추는 건지는 의외로 잘 설명하기 어렵다. 네트워크가 느려서? 그건 너무 두루뭉술하다.
지난 글에 이어 이번에는 — 버퍼링이 생기는 진짜 원인, 라이브와 VOD에서 어떻게 다르게 나타나는지, 그리고 플랫폼은 이걸 어떻게 측정하고 줄이는지를 정리한 노트다.
1. "버퍼"와 "버퍼링"은 다른 단어다
가장 먼저 정리할 게 단어다. 한국어로는 둘 다 "버퍼링"이라 부르지만 의미가 완전히 반대다.
- 버퍼 (Buffer): 미리 받아둔 데이터. 좋은 것.
- 버퍼링 (Rebuffering): 그 버퍼가 비어서 멈춘 상태. 나쁜 것.
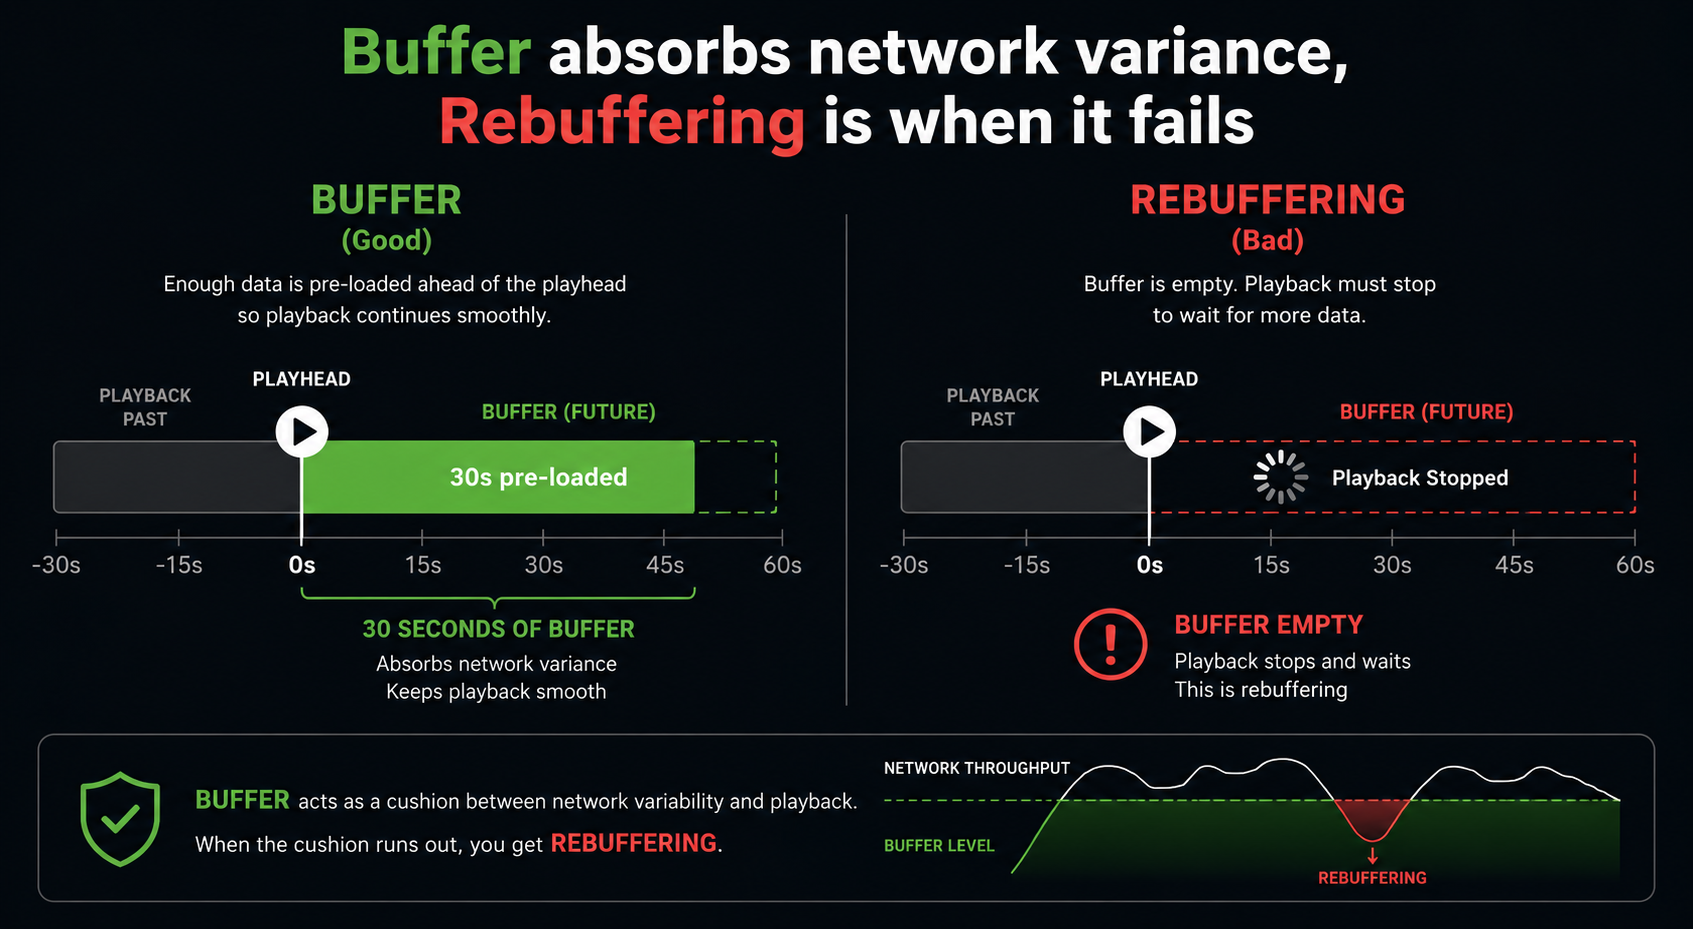
플레이어는 항상 현재 재생 위치보다 앞선 데이터를 미리 받아둔다. 보통 18~30초치. 네트워크가 잠깐 흔들려도 이 미리 받은 데이터로 계속 재생한다.
0초: 세그먼트 다운로드 5초 걸림 (네트워크 느림)
6초: 세그먼트 다운로드 1초 걸림 (정상)
12초: 세그먼트 다운로드 8초 걸림 (네트워크 매우 느림)
버퍼가 0이면 0초에 5초간 멈춘다. 30초가 차 있으면 안 멈춘다. 버퍼는 네트워크 변동성을 흡수하는 완충 장치다.
그럼 버퍼를 무한정 길게 잡으면?
여기서 라이브 스트리밍의 핵심 트레이드오프가 나온다.
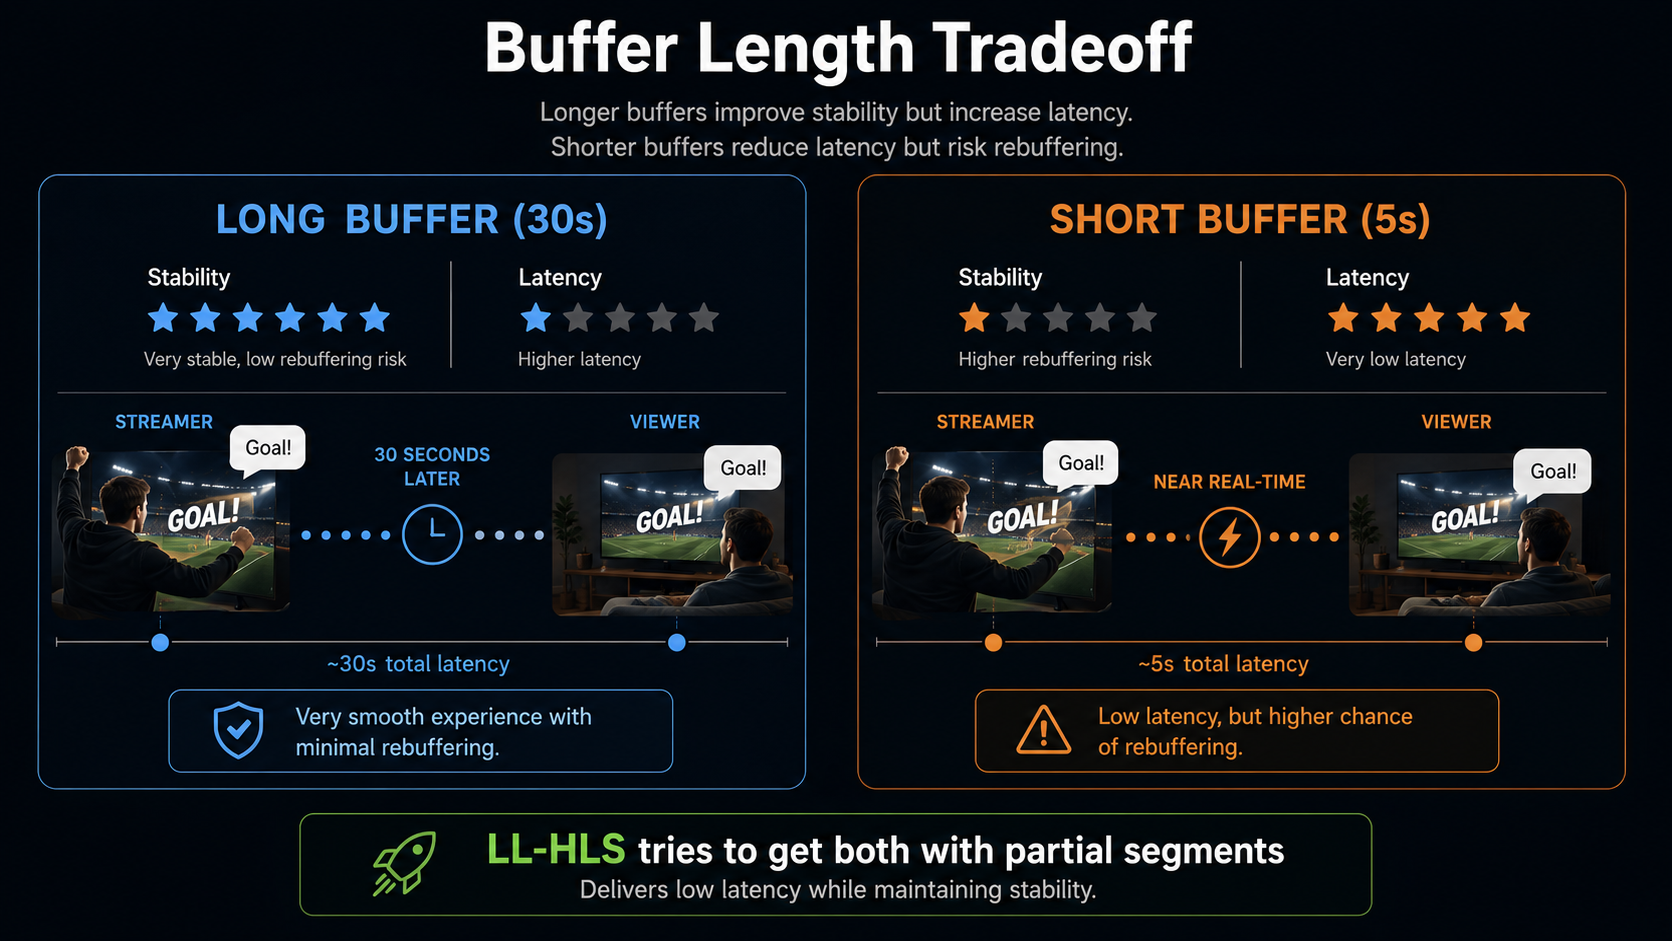
버퍼 길이 = 라이브 지연이다. 버퍼가 30초면 시청자는 스트리머보다 30초 늦게 본다. 스트리머가 "지금!" 외친 게 30초 후에 들린다.
- 버퍼 30초: 안정성 최고, 지연 최악
- 버퍼 5초: 지연 최소, 네트워크 살짝 흔들리면 바로 버퍼링
LL-HLS의 Partial Segment가 이 트레이드오프를 깨려는 시도다. 6초짜리 세그먼트를 1초짜리 조각으로 잘라서 받으면 버퍼는 짧게 유지하면서도 안정성을 어느 정도 확보할 수 있다.
2. 버퍼링의 근본 원인 — TCP의 Head-of-Line Blocking
대역폭이 충분해도 버퍼링이 일어날 수 있다. 진짜 원인은 따로 있다.
TCP는 패킷에 순서 번호(seq)를 붙여서 보낸다. 받는 쪽은 순서대로 정렬해서 애플리케이션에 넘긴다. 문제는 중간에 하나가 손실되면 뒤 패킷이 다 도착해도 못 넘긴다는 점이다.
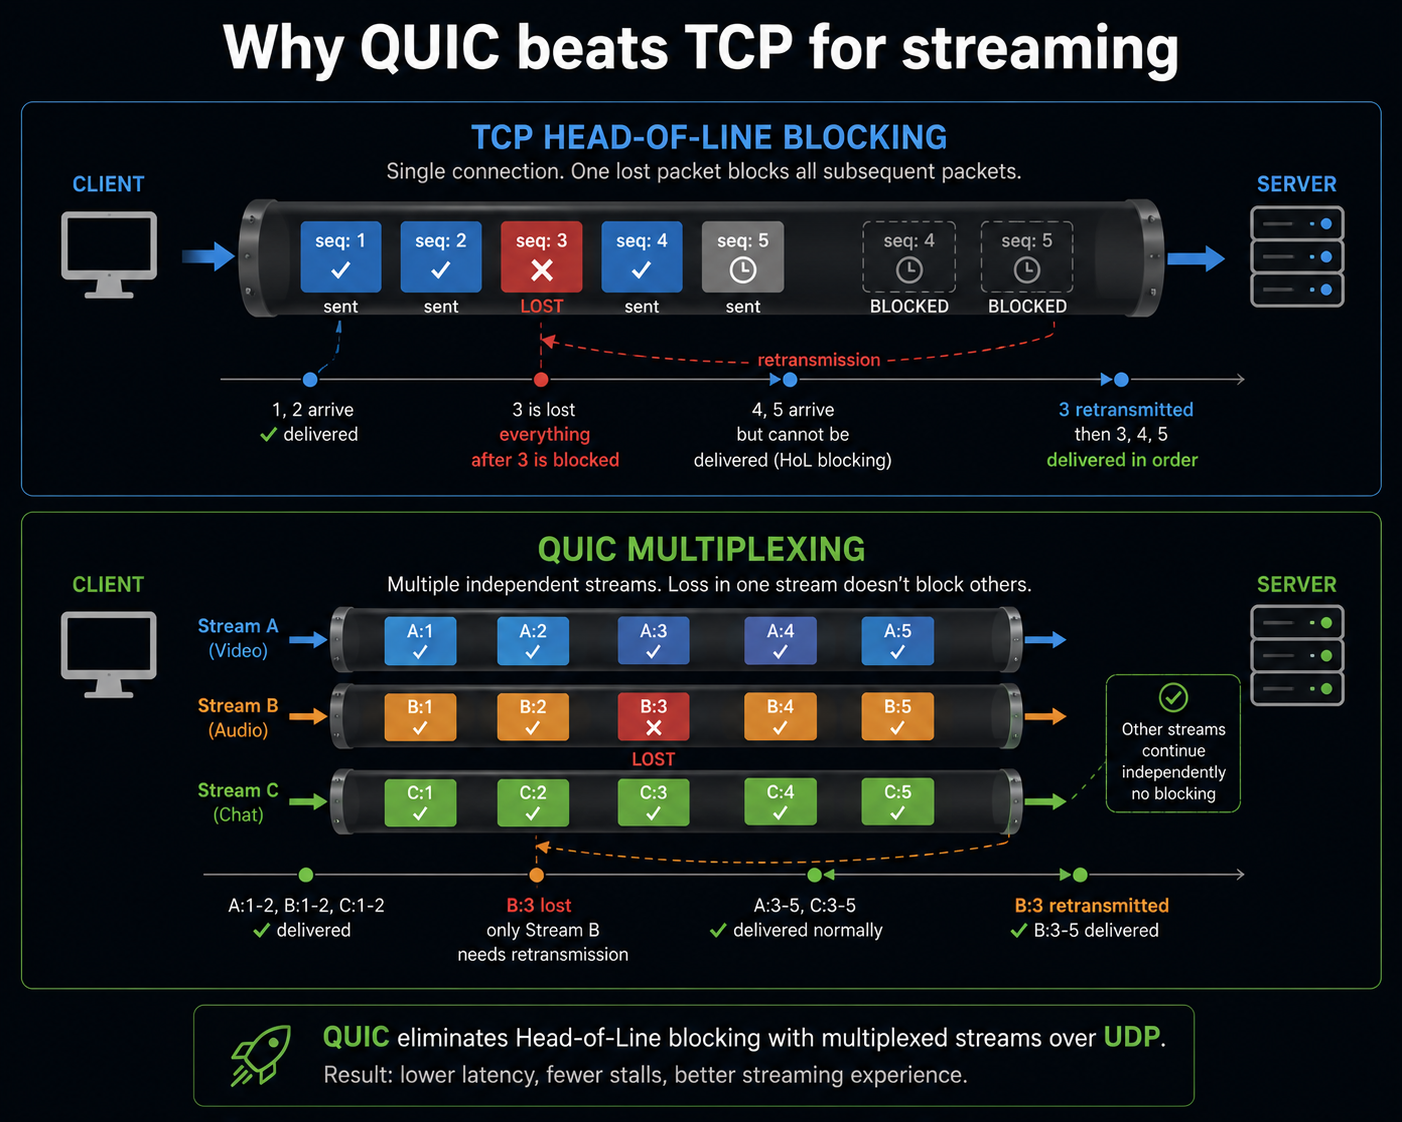
이걸 Head-of-Line Blocking (HoL Blocking) 이라고 한다. 줄 맨 앞 손님이 못 가면 뒤 손님 전부 대기.
[브라우저]                     [서버]
  │── seq:1 받음                 │
  │── seq:2 받음                 │
  │── seq:3 ❌ 손실               │
  │── seq:4 받음 → 대기 ←────────│
  │── seq:5 받음 → 대기 ←────────│
                ↑
        seq:3 재전송 올 때까지
        애플리케이션에 전달 안 함
RTT 150ms 환경에서 패킷 하나 손실 = 최소 300ms 멈춤 (재전송 요청 + 도착).
QUIC — HoL Blocking을 우회한 프로토콜
구글이 만든 QUIC이 이 문제를 해결한다. UDP 위에서 동작하지만 TCP의 신뢰성과 암호화를 다 갖고 있다.
핵심은 여러 스트림을 병렬로 다룬다는 것. 한 스트림에서 패킷 손실이 나도 다른 스트림은 계속 진행된다. HTTP/3가 QUIC 위에서 동작한다.
치지직 같은 플랫폼이 점진적으로 HTTP/3를 도입하는 이유다. 모바일 환경에서 패킷 손실이 잦으니 QUIC의 효과가 크다.
3. 라이브와 VOD는 버퍼링 양상이 완전히 다르다
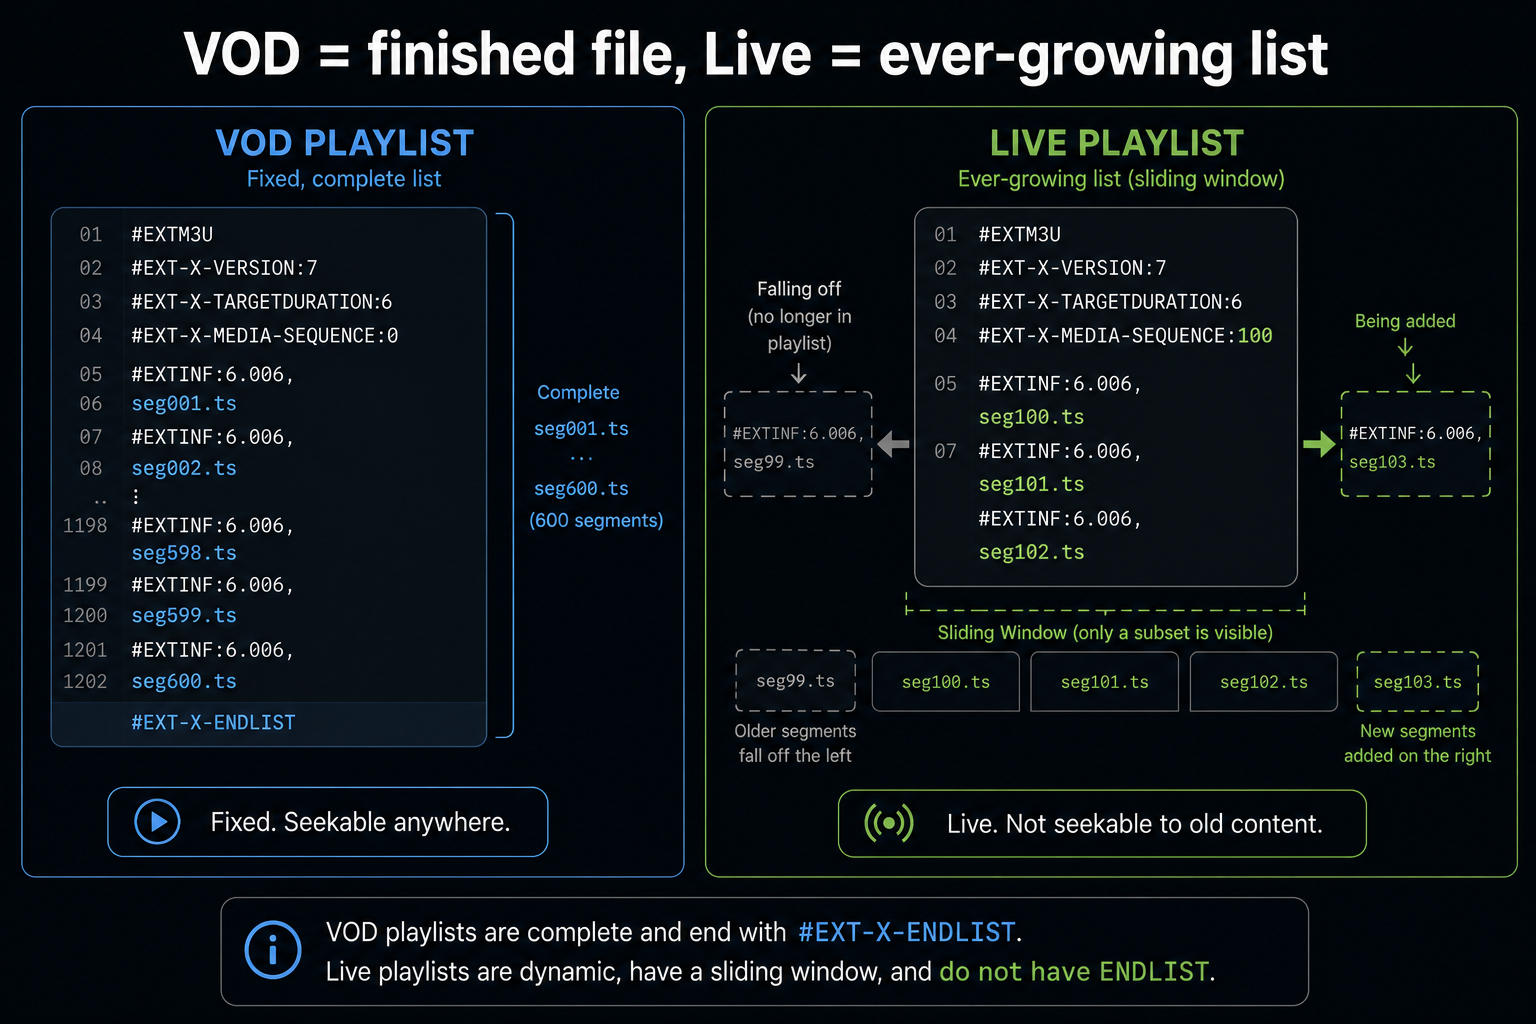
같은 HLS여도 VOD(녹화)와 라이브는 동작 방식이 다르다. 플레이리스트부터 다르다.
VOD — 끝이 정해진 영상
#EXT-X-PLAYLIST-TYPE:VOD
#EXTINF:6.000, seg001.ts
#EXTINF:6.000, seg002.ts
...
#EXTINF:6.000, seg600.ts
#EXT-X-ENDLIST              ← 끝났다는 표시
#EXT-X-ENDLIST가 핵심이다. 플레이어는 이걸 보면 자유롭게 시킹할 수 있고, 버퍼도 60초까지 마음껏 잡는다.
라이브 — Sliding Window
라이브 플레이리스트엔 #EXT-X-ENDLIST가 없다. 대신 세그먼트가 계속 추가되고 오래된 건 빠진다.
[12:00:00]                 [12:00:06]
seg100, seg101, seg102  →  seg101, seg102, seg103
                                              ↑ 새로 추가
플레이어는 6초마다 playlist.m3u8을 다시 받아서 새 세그먼트를 확인한다. 이걸 playlist polling이라고 한다.
라이브 엣지와 채팅 지연
라이브에서 시청자가 보는 가장 최신 시점을 Live Edge라고 한다. 그런데 시청자는 절대 진짜 실시간을 못 본다.
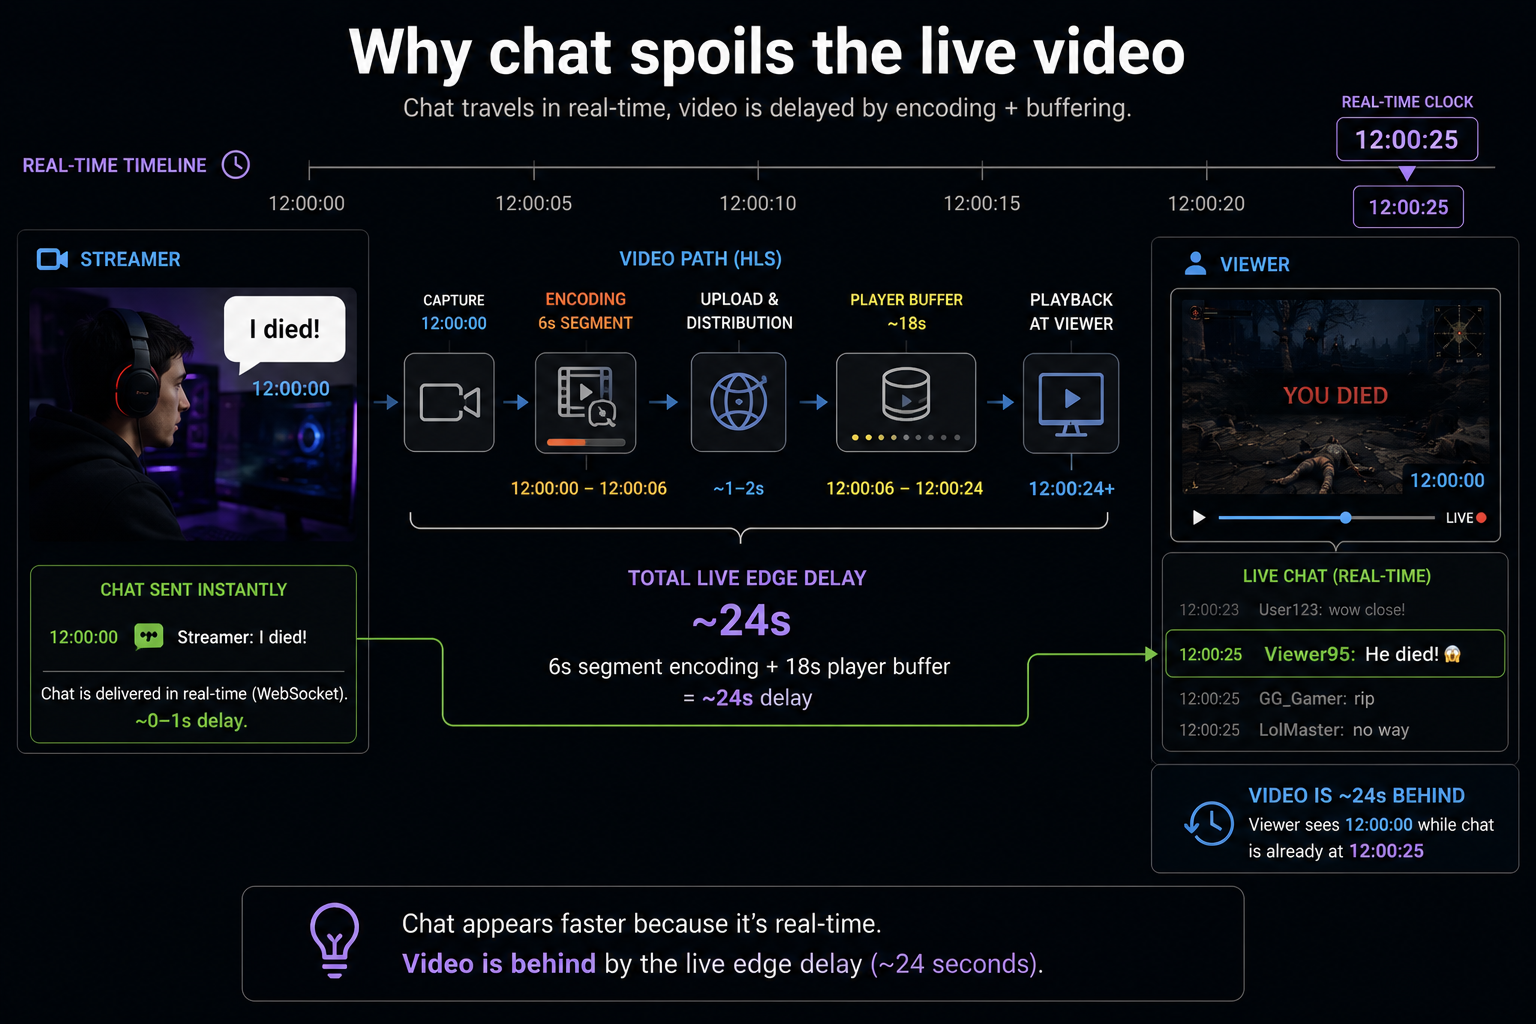
세그먼트 인코딩 6초 + 플레이어 버퍼 12~18초 = 총 18~25초 지연이 기본이다.
이래서 채팅이 영상보다 빠르다. "지금 죽었어!" 채팅이 떴는데 영상은 18초 뒤에 죽는 장면이 나온다. 게임 스포일러가 채팅으로 먼저 새는 이유.
라이브에서 버퍼링 후 복구 — 점프
VOD에선 버퍼링 후 끊긴 시점부터 이어보면 된다. 라이브는 다르다.
[12:00:00] 시청자가 seg100 보고 있음
[12:00:05] 네트워크 끊김. 버퍼링 시작
[12:00:30] 네트워크 복구
            → 그 사이 방송은 seg105까지 진행됨
            → 시청자는 어디부터 봐야 하나?
치지직 같은 라이브 플랫폼은 보통 자동으로 라이브 엣지로 점프시킨다. 끊긴 30초는 못 보지만 채팅과 영상 동기화가 더 중요하기 때문이다.
// hls.js 라이브 설정
hls.config = {
  liveSyncDuration: 18,         // 라이브 엣지에서 18초 뒤
  liveMaxLatencyDuration: 30,   // 30초 이상 처지면 점프
};
4. 모바일 환경이 버퍼링의 진짜 무대다
치지직 시청자 60~70%가 모바일이다. PC와는 완전히 다른 변수가 있다.
와이파이 ↔ LTE 핸드오버
지하철에서 역 근처는 와이파이, 터널에선 LTE. 자동 전환된다. 이때:
[와이파이 → LTE]
  Public IP 바뀜 → 기존 TCP 연결 끊김
  → 새 연결 핸드셰이크 (RTT 3회 = 300ms)
  → 그 사이 버퍼링
QUIC의 Connection Migration이 이 문제를 우회한다. IP가 바뀌어도 같은 연결을 유지한다. 이 기능 하나만으로도 모바일 시청 경험이 크게 개선된다.
디코딩 부하 — H.265를 왜 안 쓰나
라이브 플랫폼이 H.264만 쓰는 이유가 모바일이다.
저가형 안드로이드:
  H.264 1080p30: OK
  H.265 1080p60: 디코딩 불가

플래그십:
  H.265, AV1 다 OK
스트리머가 H.265로 송출하면 저가폰 시청자가 못 본다. 치지직이 H.264 유지하는 게 호환성 100%를 위해서다.
모바일 ABR이 어려운 이유
PC ABR은 단순하다 — 대역폭 측정 → 적정 화질 선택. 모바일은 변수가 너무 많다.
모바일 ABR 결정 요인:
- 측정 대역폭
- 신호 강도 변화 추세
- 배터리 상태 (배터리 20% 이하면 CPU 클럭 제한)
- 디바이스 디코딩 능력
- 화면 크기 (작은 화면엔 480p로 충분)
- 데이터 요금제
- 백그라운드 앱 영향
- 와이파이 vs 셀룰러
hls.js, Shaka Player 같은 라이브러리가 이런 휴리스틱을 내장하고 있다. 모바일 플레이어 엔지니어의 핵심 일이 이 알고리즘 튜닝이다.
5. 플랫폼은 버퍼링을 어떻게 측정하고 줄이나
"측정해야 줄일 수 있다." 플랫폼 엔지니어가 보는 핵심 지표를 QoE (Quality of Experience) 라고 한다.
핵심 QoE 지표
| 지표 | 의미 | 업계 기준 |
|---|---|---|
| Rebuffering Ratio | 시청 시간 중 멈춘 시간 비율 | 1% 미만 |
| Startup Time | 플레이 → 첫 프레임까지 | 1초 미만 |
| Video Start Failure | 아예 시작 못한 비율 | 1% 미만 |
| Average Bitrate | 시청자가 받은 평균 화질 | ABR 품질 지표 |
| Bitrate Switch Frequency | 화질 전환 빈도 | 낮을수록 좋음 |
버퍼링은 매출 직결 지표다
시작 지연·재버퍼링·시청 시간의 관계를 볼 때는 사용자군과 콘텐츠, 네트워크 조건을 함께 비교해야 한다. 기존에 Conviva 연구로 적었던 “2초면 6% 이탈, 재버퍼링 1%면 시청 시간 5% 감소”는 대응하는 원문과 조건을 확인할 수 없어 철회했다. 특정 비율을 모든 서비스의 매출 변화로 환산하지 않는다.
Beacon — 클라이언트가 자기 상태를 보고한다
hls.on(Hls.Events.BUFFER_STALLED, () => {
  sendBeacon({
    event: 'rebuffer_start',
    timestamp: Date.now(),
    currentQuality: '720p',
    bufferLength: 0,
    bandwidth: estimatedBandwidth
  });
});
수집 API로 받은 클라이언트 이벤트를 집계한 뒤 메트릭·분석 저장소와 대시보드로 연결할 수 있다. 이는 가능한 설계 예시이며 치지직의 내부 구조를 확인한 설명이 아니다. 문제가 어디서 생기는지 안 보이면 고칠 수가 없다.
Origin Shield — 라이브 인프라의 필수 패턴
CDN 엣지가 100개 있다고 하자. 새 라이브 세그먼트가 만들어지자마자 100개 엣지에서 동시에 Origin으로 요청을 보내면? Origin이 죽는다. 이걸 Thundering Herd라고 한다.
해결책이 Origin Shield — 엣지와 Origin 사이에 중간 캐시 레이어를 한 단계 더 두는 것.
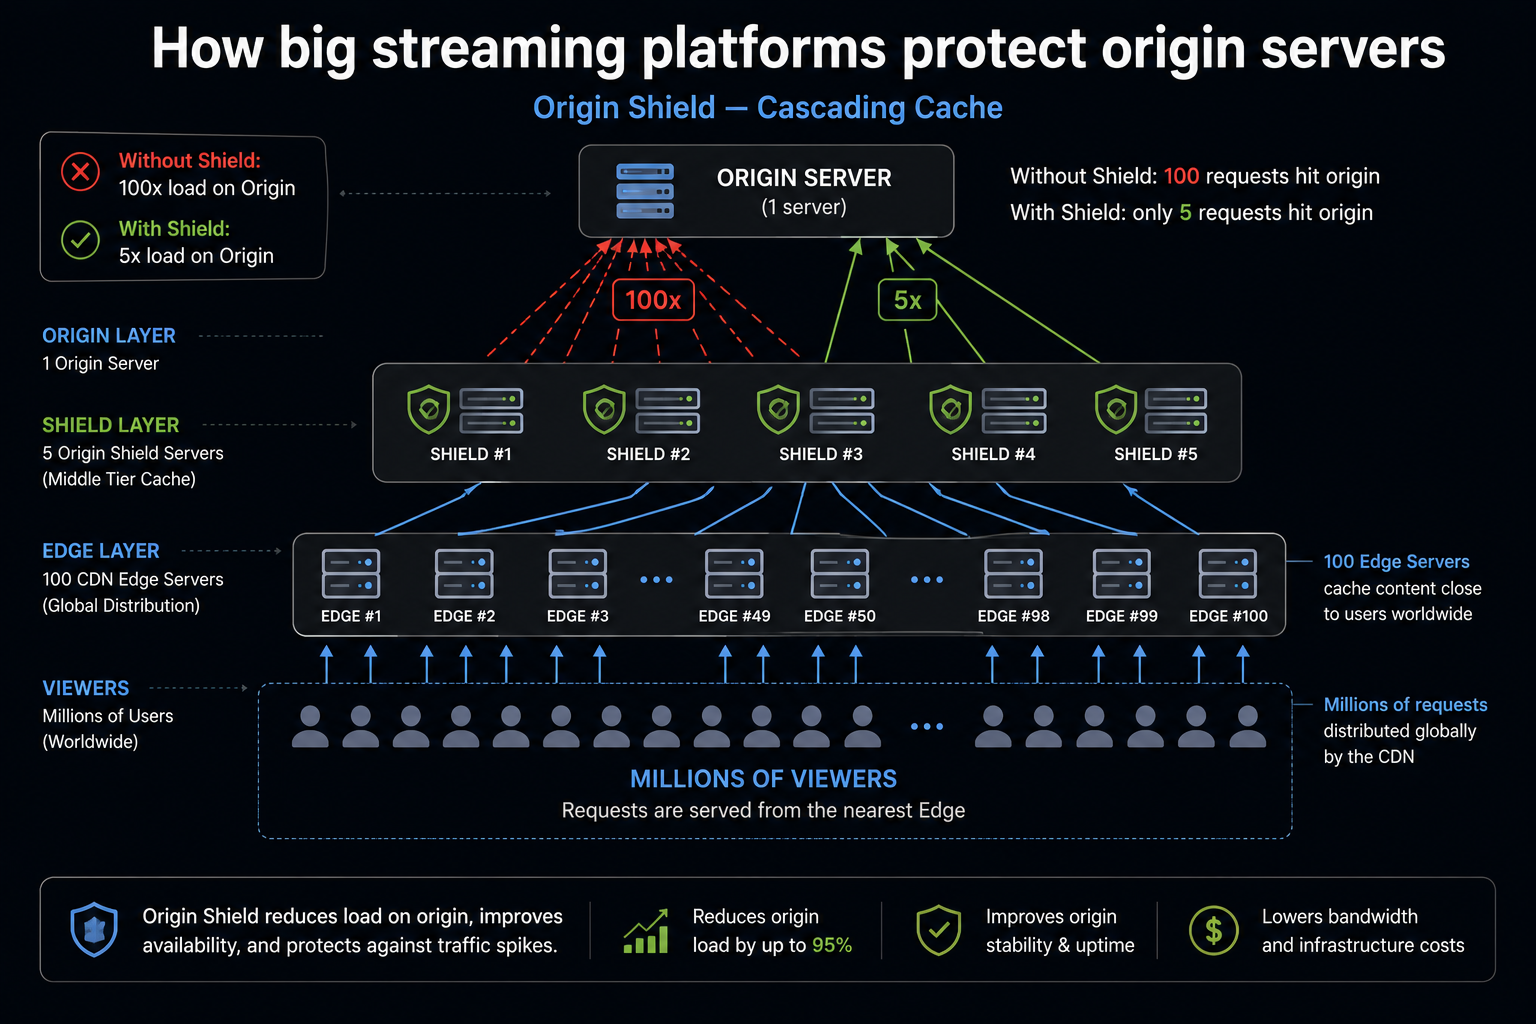
시청자 → 엣지 (100개) → Shield (5개) → Origin (1개)
100개 엣지가 5개 Shield로 요청을 모으고, 5개 Shield만 Origin에 요청한다. Origin 부하가 100배 → 5배로 줄어든다. Cascading Cache 패턴이다.
Pre-positioning — 인기 방송 미리 준비
인기 스트리머는 방송 시간이 예측 가능하다.
[방송 시작 5분 전]
  CDN 엣지들이 빈 세그먼트 미리 요청
  → 캐시 워밍업
  → 방송 시작 직후 Thundering Herd 방지
A/B 테스트로 정책을 결정한다
버퍼 길이를 줄이고 싶다. 그런데 줄이면 버퍼링이 늘 수도 있다. 어떻게 결정하나?
[실험 설계]
A 그룹 (50%): 버퍼 18초
B 그룹 (50%): 버퍼 12초

가상의 7일 실험 결과를 넣어 보는 예시 (실제 수행하지 않음):
  A: Rebuffering 0.5%, 지연 22초
  B: Rebuffering 0.8%, 지연 16초

결정: A 유지 (Rebuffering이 더 중요)
위 숫자는 실험 설계 설명용이다. 실제로는 표본 수, 불확실성, 사용자군과 사전에 정한 판단 기준을 확인해야 정책을 선택할 수 있다.
정리하면
버퍼링은 단순히 "네트워크가 느려서"가 아니다. 여러 층에서 나오는 문제다.
- 프로토콜 층 — TCP의 순서 보장이 대기에 영향을 준다. QUIC도 손실·혼잡·같은 스트림의 데이터 의존성을 없애지는 않는다
- 버퍼 정책 층 — 안정성 vs 라이브 지연 트레이드오프, LL-HLS의 Partial Segment
- 디바이스 층 — 모바일 핸드오버, 디코딩 부하, 배터리 — 모바일 ABR이 PC보다 훨씬 복잡
- 운영 층 — QoE 측정 → Prometheus/Grafana → Origin Shield, Pre-positioning, A/B 테스트
네 층을 함께 관측해야 원인을 좁힐 수 있다. 버퍼링 감소가 시청 시간과 매출에 미치는 영향은 해당 서비스의 데이터로 검증해야 한다.
다음 글에선 CDN을 한층 더 깊이 — 라이브 전용 CDN 운영과 한계를 정리할 예정이다.
참고