2026-10-29 정정 — 치지직의 실제 구조·6.2초 측정값이라는 표현을 철회했습니다. 본문의 단계 시간·처리량·비용·할인·장애 복구 시간·A/B 결과는 검증된 실적이나 현재 가격이 아닌 설명용 가정입니다.
이 글은 가상의 라이브 파이프라인을 구성해 책임과 비용을 비교하는 학습 노트다. 처음부터 등장하는 6.2초는 단계별 시간을 임의로 배정한 예시이며, 치지직이나 다른 서비스에서 측정한 시작 지연이 아니다.
설명을 위해 7개 층으로 나누었다. 반드시 각각을 마이크로서비스로 배포해야 한다는 뜻은 아니다. 인제스트 / 트랜스코딩 / 패키저 / Origin / CDN / 관제 / 시청자 — 각 층이 다른 자원 패턴, 다른 인스턴스, 다른 스케일링 전략.
이번 글은 지난 글의 FFmpeg, 지난 글의 ABR Ladder, 지난 글의 NVENC, 지난 글의 CMAF를 다 합쳐서 라이브 트랜스코딩 인프라 운영의 모든 것 — 아키텍처 / 스케줄러 / 큐 / 장애 처리 / 비용 최적화 — 를 정리한 노트다.
1. 7층 마이크로서비스 — 라이브 트랜스코딩의 전체 그림
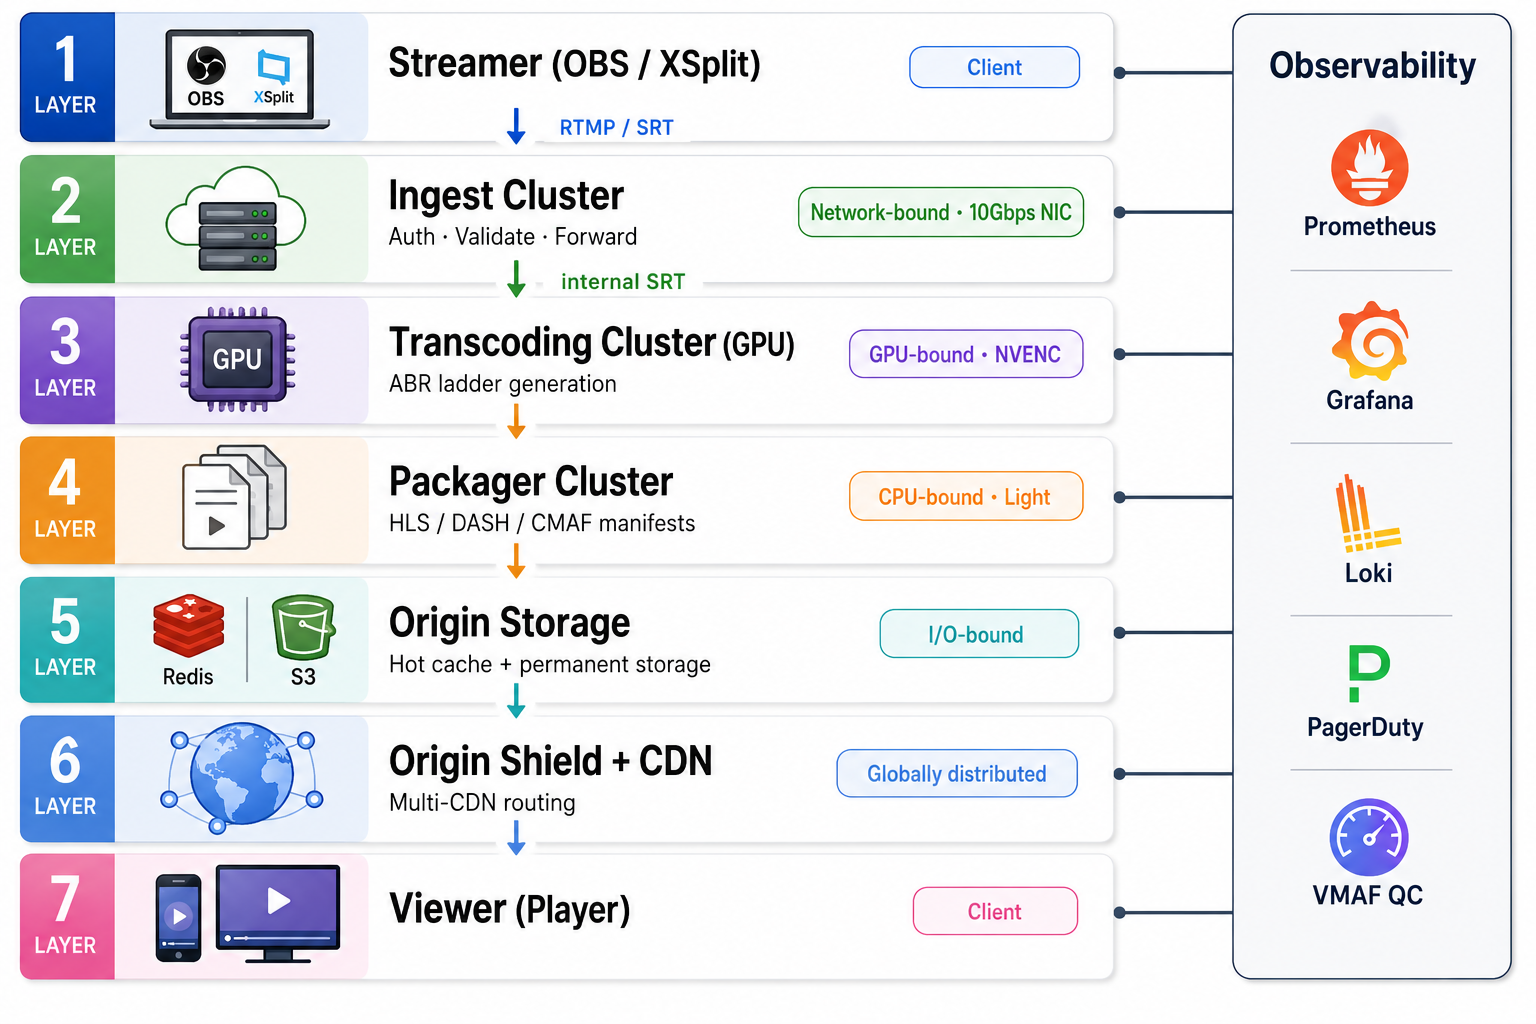
각 층은 자원 패턴이 다르다.
| # | 층 | 자원 패턴 | 인스턴스 | 가격 (월) |
|---|---|---|---|---|
| 1 | Streamer | Client | OBS/XSplit | - |
| 2 | Ingest | Network-bound (10 Gbps NIC) | c6i.4xlarge | $504 |
| 3 | Transcoding | GPU-bound (NVENC) | g5.xlarge (A10) | $725 |
| 4 | Packager | CPU-bound (가벼움) | c6i.2xlarge | $246 |
| 5 | Origin Storage | I/O-bound | Redis Cluster + S3 | 가변 |
| 6 | Origin Shield + CDN | 글로벌 분산 | Multi-CDN | 트래픽 비례 |
| 7 | Viewer | Client | Player | - |
같은 노드에 묶으면 병목을 함께 관리해야 한다. GPU 강한 노드에 인제스트 묶으면 NIC가 놀고, 인제스트 강한 노드에 트랜스코딩 넣으면 GPU 모자람. 분리해야 인스턴스 타입 맞추기 가능.
2. 누적 시간을 6.2초로 가정한 예시
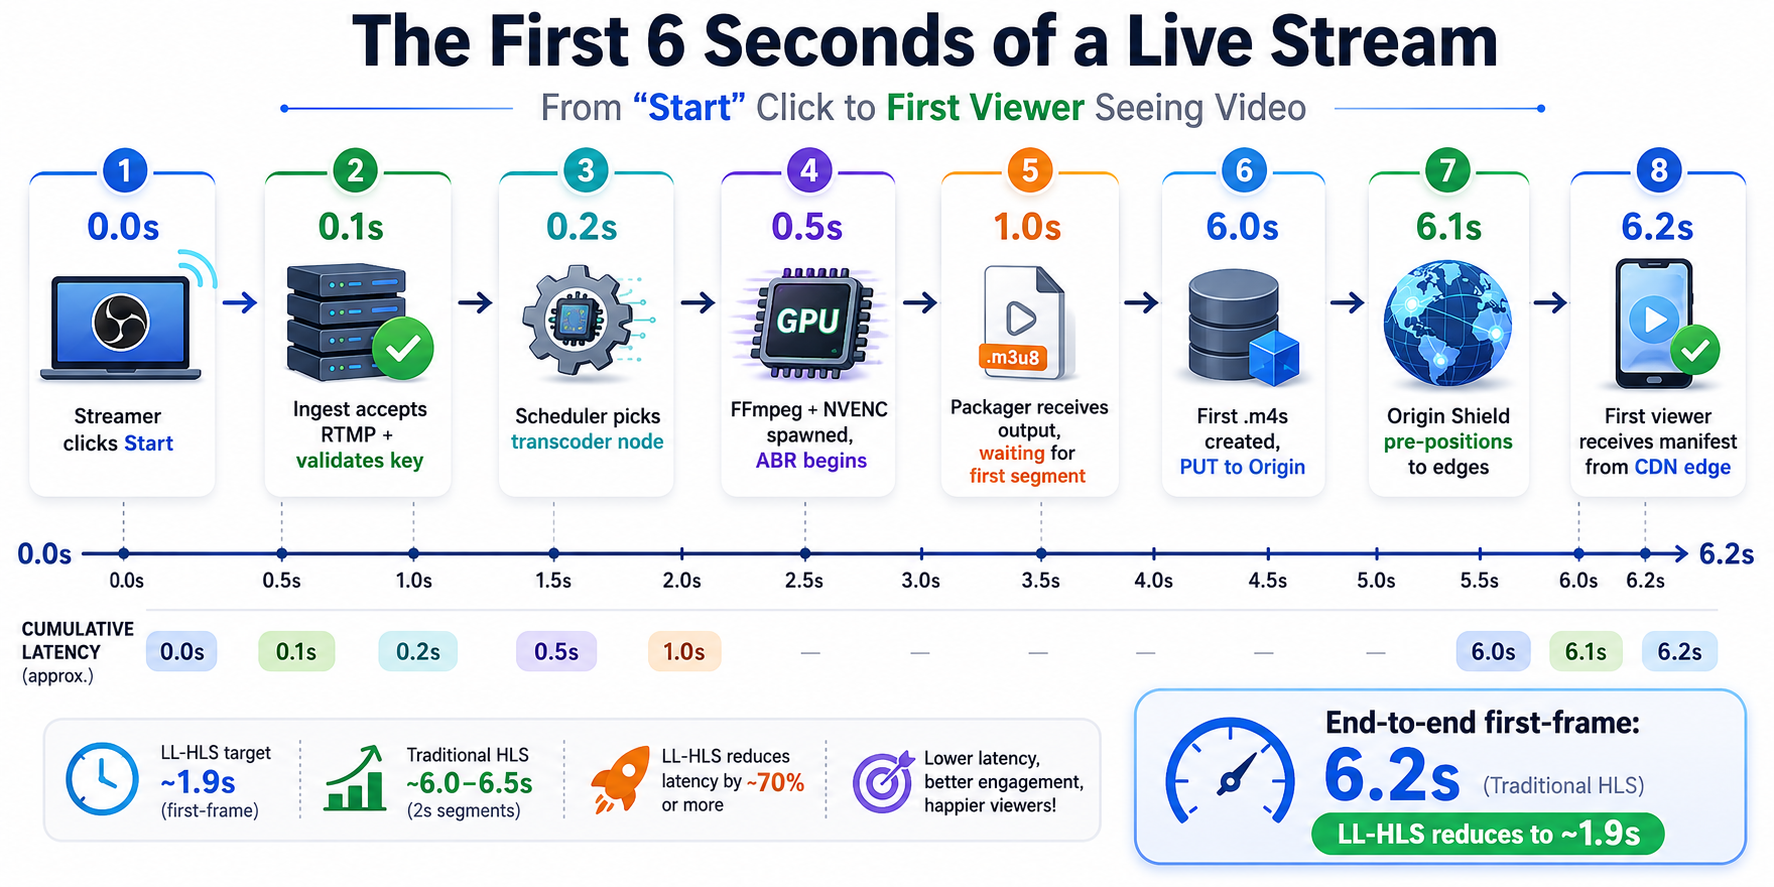
각 단계 누적 지연을 ECharts로 분해.
이 예시에서 패키저 첫 출력은 1초, 첫 PUT은 6초이므로 두 점 사이를 5초로 배정했다. 이를 모든 서비스의 인코딩 대기로 해석할 수 없다. LL-HLS도 고정적으로 5초를 1초로 바꿔 주지 않는다. 아래 조작 모형에서 가정한 대기 예산을 따로 비교할 수 있다.
3. 비용 분배 — 어디서 절감해야 ROI 큰가
CDN(45%) + 트랜스코딩(25%) = 70%. 이 둘에서 절감해야 효과 큼. 인제스트/패키저 5%씩은 최적화 ROI 낮음.
4. 인스턴스 가격 vs 처리량 — GPU 선택의 진실
채널당 단가: T4 $76, A10 $73, RTX 4080 $235, c6i CPU $315. A10이 처리량 2배에 가격 1.9배. T4보다 약간 우위. 대형 인프라가 A10으로 옮겨가는 이유.
5. 인제스트 클러스터
| 항목 | 값 |
|---|---|
| 인스턴스 | c6i.4xlarge (16 vCPU, 32GB) |
| NIC | 12.5 Gbps |
| 가격 | $0.70/시간 ($504/월) |
| 소프트웨어 | Nginx-RTMP / SRS / 자체 Go |
| 한 노드 동시 인제스트 | ~200~300 채널 (RTMP 연결 수 한계) |
부하는 네트워크보다 TCP 연결 수. Anycast IP로 지역별 라우팅.
rtmp {
  server {
    listen 1935;
    application live {
      live on;
      on_publish http://auth-service/verify;
      push rtmp://transcoder-primary/live;
      push rtmp://transcoder-backup/live;
      record off;
    }
  }
}
on_publish로 스트림 키 검증. push 두 개로 active-active.
6. 트랜스코딩 클러스터 — A10이 가성비 정점
flowchart LR
  S[Scheduler] -->|새 스트림| Q{큐 깊이?}
  Q -->|여유| N[GPU 노드 풀<br/>T4 / A10]
  Q -->|부하 큼| HPA[HPA<br/>스케일 업]
  HPA --> NEW[새 노드 spawn]
  NEW --> N
  N --> FF[FFmpeg + NVENC<br/>ABR Ladder 5단]
  FF --> PKG[패키저로 출력]
채널 패킹:
방송 1개 = ABR 5단 ladder
= 1080p60 + 720p60 + 720p30 + 480p30 + 360p30
≈ A10 NVENC 처리량 5/15 = 33%
→ A10 1대당 방송 3개 (안전 마진)
7. 패키저 클러스터
| 항목 | 값 |
|---|---|
| 인스턴스 | c6i.2xlarge (8 vCPU, 16GB) |
| 가격 | $0.34/시간 ($246/월) |
| 소프트웨어 | Shaka Packager + 매니페스트 생성기 (Go) |
| 한 노드 처리 | 50~100 채널 |
CMAF 변환 가벼움. 인스턴스 적게.
8. Origin Storage — Hot/Warm/Cold 계층
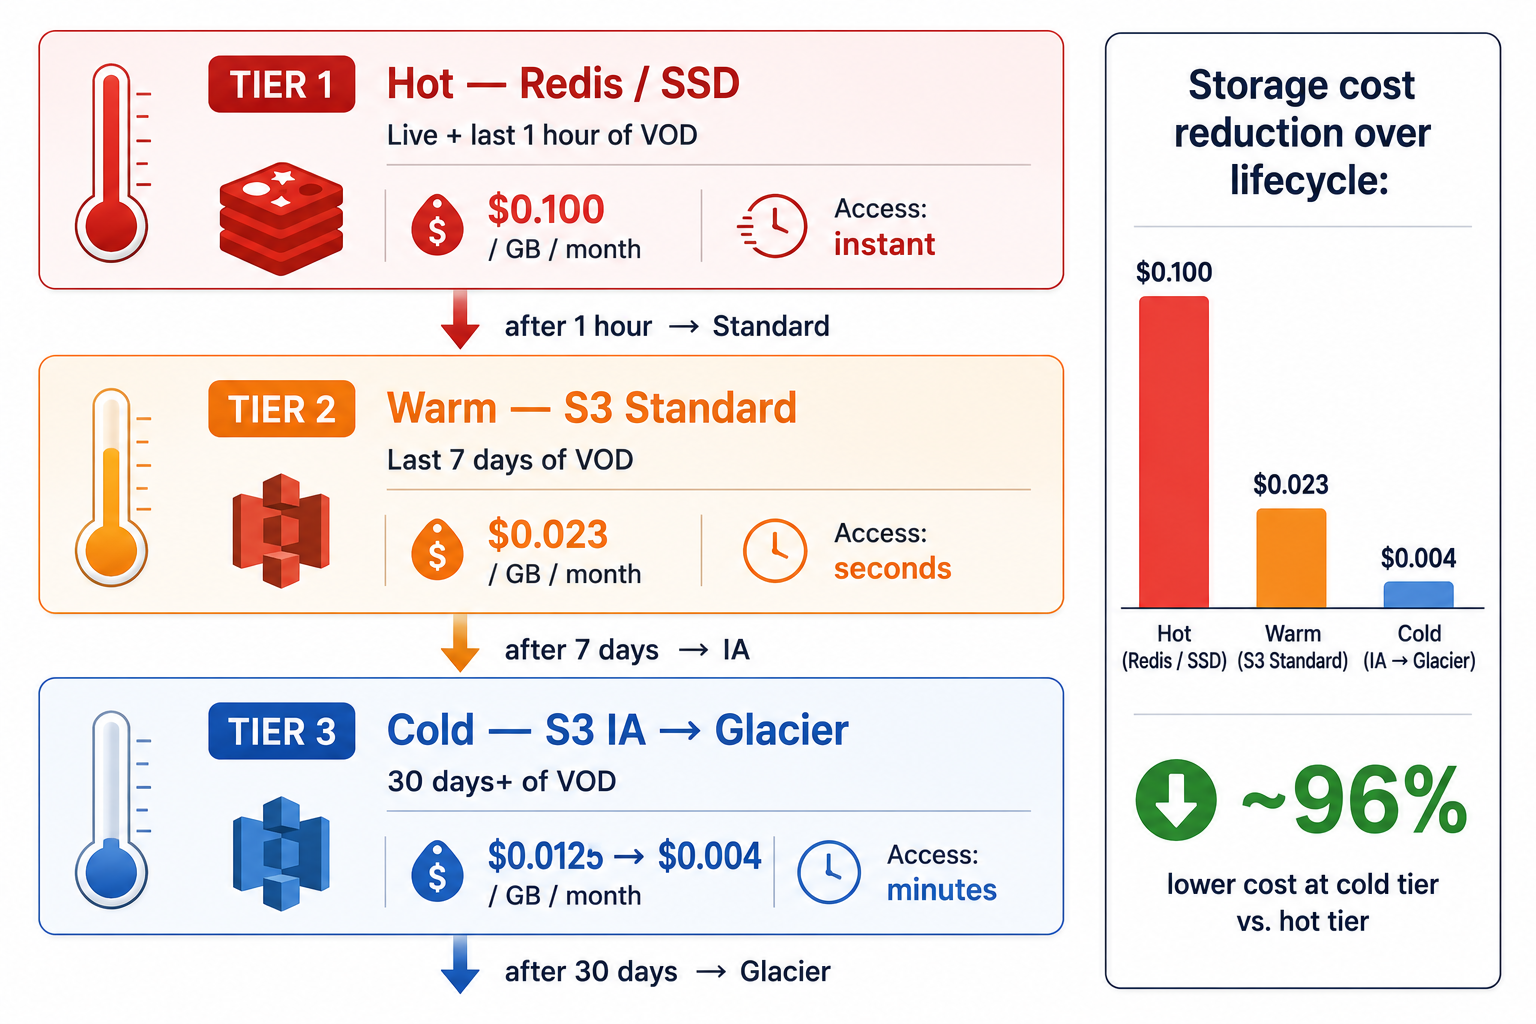
| 계층 | 저장소 | 보관 기간 | 가격/GB/월 | 접근 |
|---|---|---|---|---|
| Hot | Redis / SSD | 라이브 + 1시간 | $0.100 | 즉시 |
| Warm | S3 Standard | 7일 | $0.023 | 초 |
| IA | S3 Infrequent Access | 30일 | $0.0125 | 초 |
| Cold | S3 Glacier | 365일 | $0.004 | 분 |
자동 라이프사이클:
Rules:
  - Hot → Standard after 1 hour
  - Standard → IA after 7 days
  - IA → Glacier after 30 days
  - Expire after 365 days
# Pull Origin 통합 라우팅
def get_segment(path):
    if redis.exists(path): return redis.get(path)
    if s3.exists(path):    return s3.get(path)
    return 404
9. Multi-CDN GSLB 라우팅
flowchart TB
  V[시청자 DNS 쿼리] --> GSLB[GSLB / NS1<br/>지역+시간+가격 판단]
  GSLB -->|한국 피크| AK[Akamai 국내 PoP]
  GSLB -->|모바일| CF[Cloudflare HTTP/3]
  GSLB -->|미국 서부| CW[CloudFront]
  GSLB -->|한국 새벽| FA[Fastly]
  AK --> ORG[Origin Shield]
  CF --> ORG
  CW --> ORG
  FA --> ORG
CDN 한 곳 장애 시 즉시 가중치 0으로 만들어 차단. 다른 CDN으로 100% 전환.
10. Origin Shield — 중간 캐시의 역할
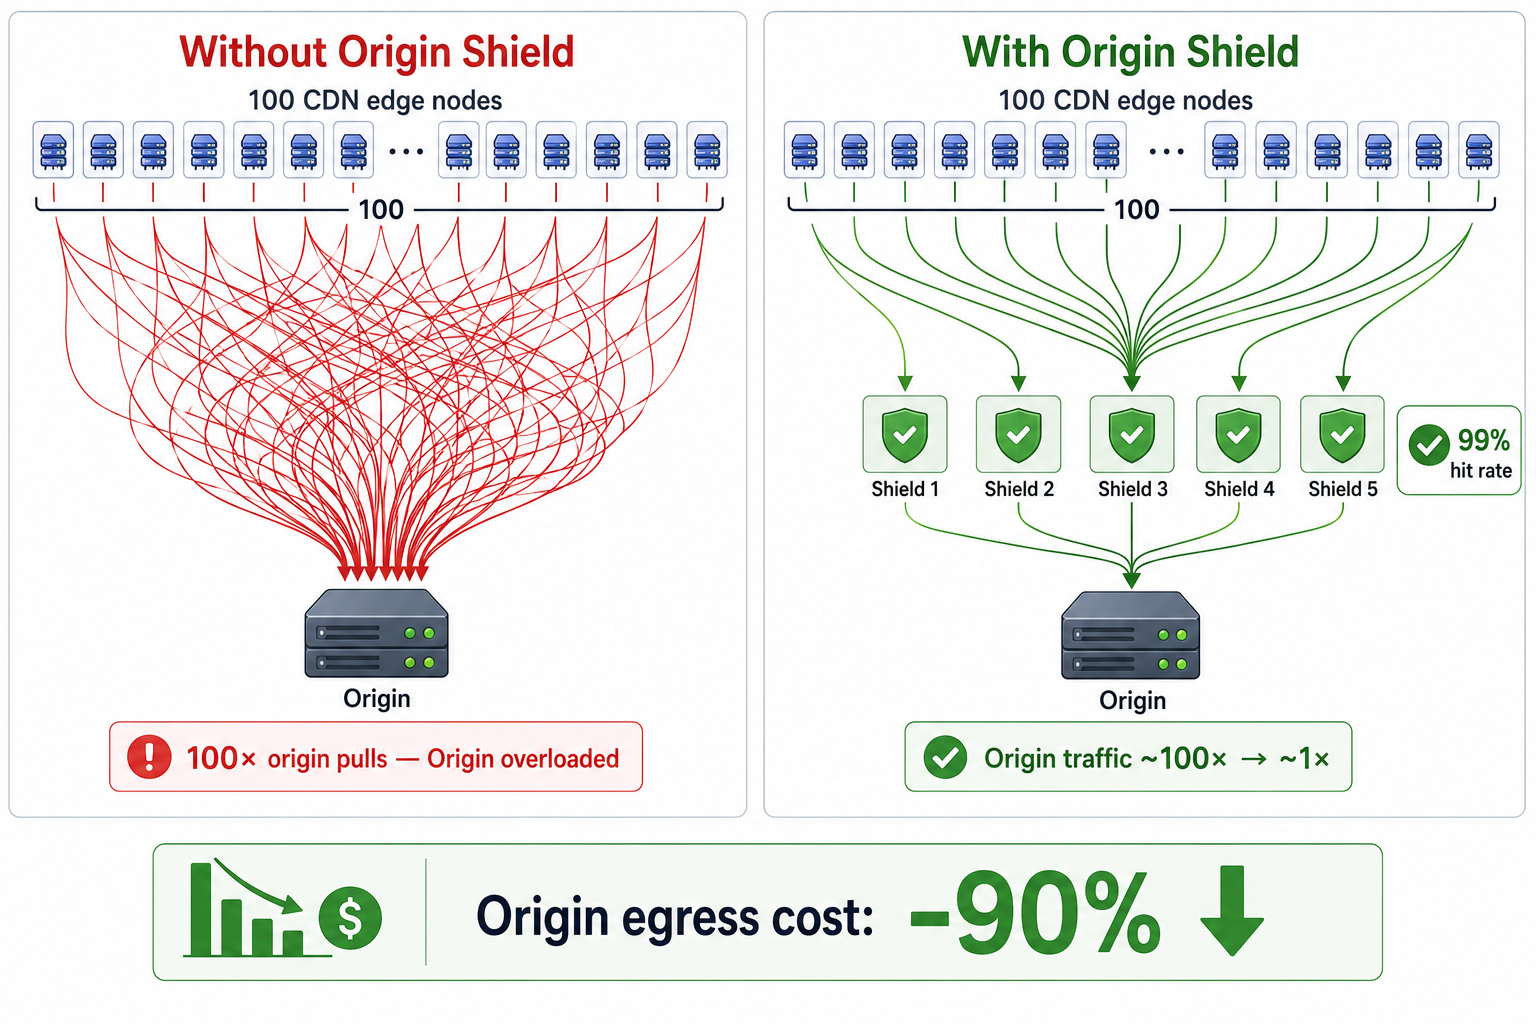
Edge 100개가 Origin 직접 Pull   →  Origin 트래픽 100배
Edge 100개 → Shield 5개 → Origin → Origin 트래픽 1배
Shield의 hit rate와 Origin 바이트 절감률은 같은 지표가 아니다. 캐시 키·TTL·요청 분포·객체 크기를 측정해야 비용 효과를 판단할 수 있다.
11. 스케줄러 4종 알고리즘 비교
| 스케줄러 | 장점 | 단점 | 노드 활용률 |
|---|---|---|---|
| Round Robin | 단순 | 부하 무시, 죽은 노드 할당 | 균등 |
| Least-Load | 부하 균등 | Bin packing 안 됨 | 균등 |
| Bin Packing | 빈 노드 종료 → 30% 절감 | 한 노드 집중 부담 | 양극화 |
| Tier | 인기 스트리머 우선 | 복잡 | 등급별 |
flowchart TB
  S[새 스트림] --> T{Tier?}
  T -->|Tier 1<br/>Top 1%| P1[Premium A10 풀]
  T -->|Tier 2<br/>Top 10%| P2[Standard T4/A10 풀]
  T -->|Tier 3| P3[Budget T4/x264 풀]
  P1 --> L1[풀 내 Least-Load]
  P2 --> L2[풀 내 Bin Packing]
  P3 --> L3[풀 내 Bin Packing]
  L1 --> N1[노드 할당]
  L2 --> N2[노드 할당]
  L3 --> N3[노드 할당]
12. Bin Packing vs Load Balancing — 빈 노드 끄기
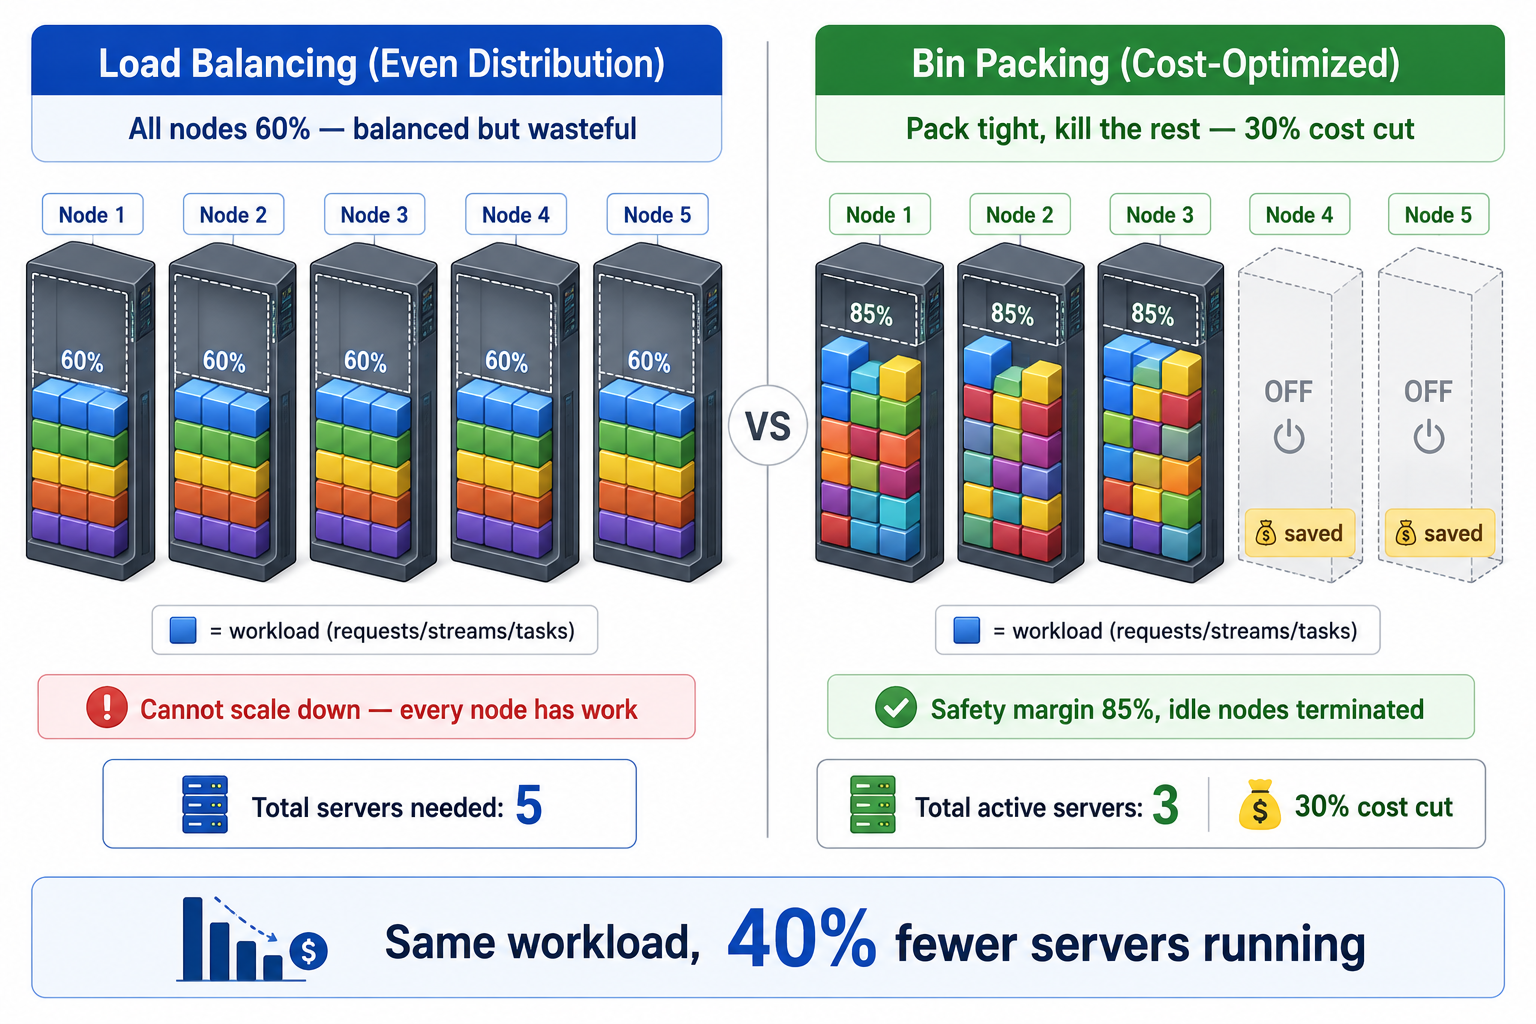
Load Balancing: 5대 다 60% → 끌 수 없음. Bin Packing: 3대 85% + 2대 OFF → 40% 비용 절감.
def assign(stream):
    candidates = [(n, load(n)) for n in healthy() if load(n) < 0.85]
    candidates.sort(key=lambda x: -x[1])  # 부하 높은 순
    return candidates[0][0] if candidates else spawn_new()
13. Tier Scheduling — 인기에 따른 GPU 차등
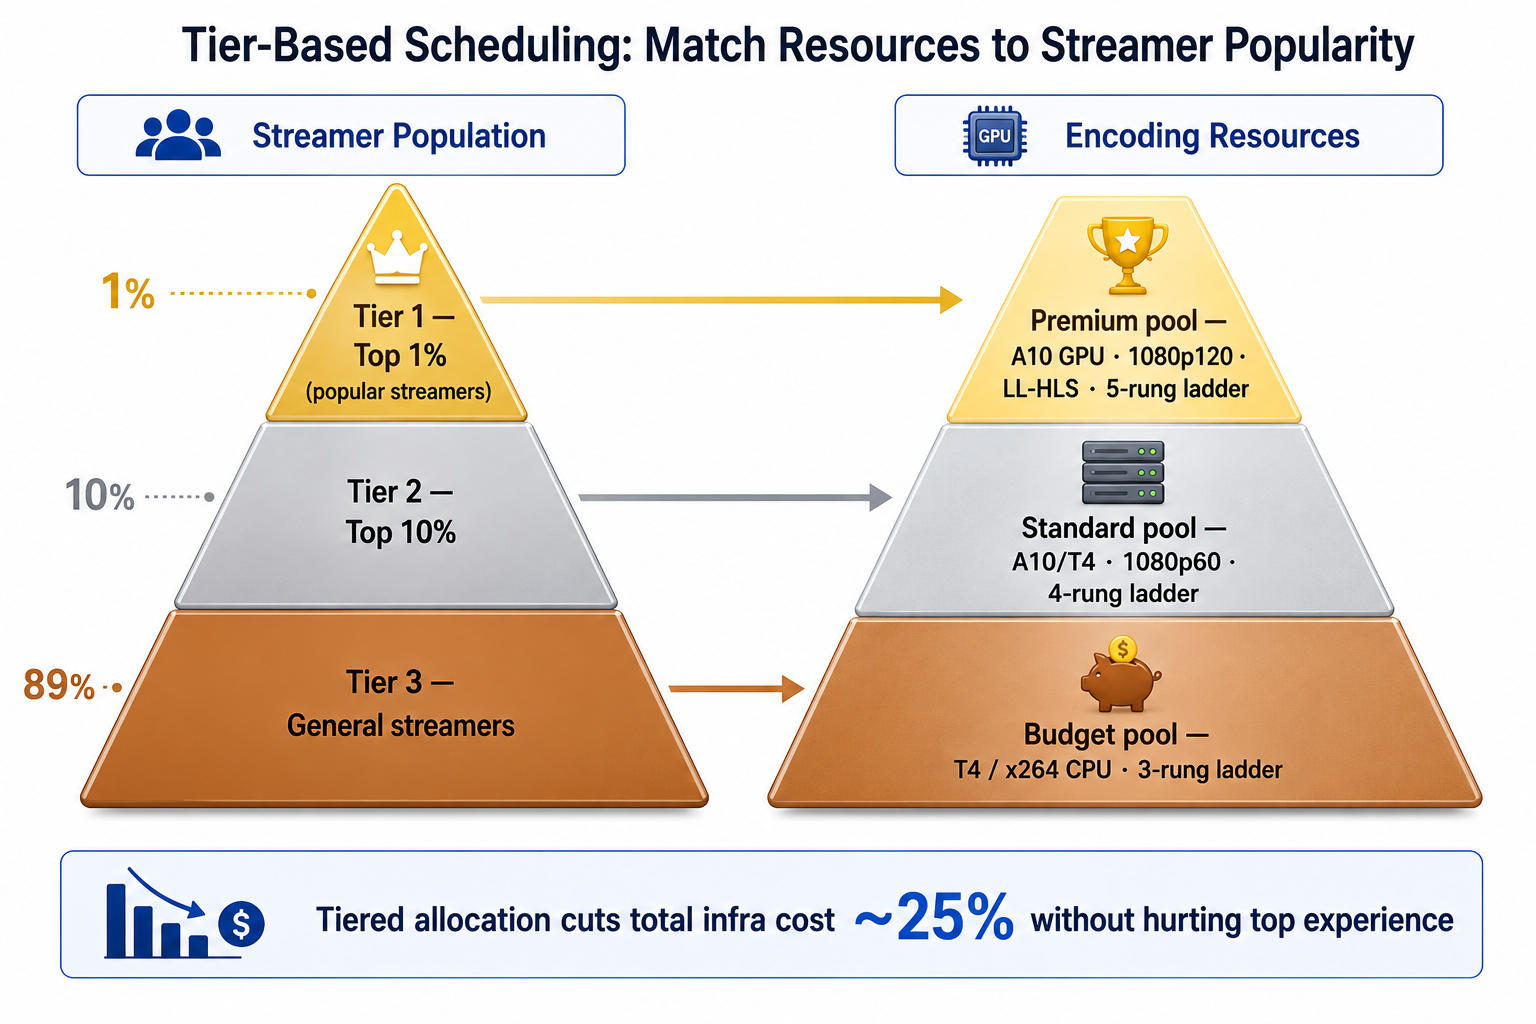
Top 1%가 시청자 80% 차지 → 인프라 비용 40% 정당화. 일반 90%는 budget 풀로 보내 비용 압축. 전체 비용 25% 절감.
14. 큐 시스템 — Redis Streams vs Kafka vs SRT
| 큐 | 처리량 | 운영 부담 | 지연 | 적합 규모 |
|---|---|---|---|---|
| SRT (큐 없음) | 채널당 자체 버퍼 | 0 | 120ms | 소규모 |
| Redis Streams | ~10만 msg/s | 중 | <10ms | 중규모 |
| Kafka | 100만+ msg/s | 큼 | <50ms | 대규모 |
flowchart LR
  ING[인제스트] -->|xadd<br/>maxlen=300| RS[Redis Stream<br/>stream:S_ID]
  RS -->|xread block| TR[트랜스코딩 컨슈머]
  RS -.->|maxlen 초과 시<br/>오래된 것 자동 삭제| GONE[(drop)]
  TR -->|처리 느림| BP[백프레셔<br/>인제스트 속도 조절]
maxlen=300 (6초 @ 50fps) — 라이브용 짧은 버퍼.
# Redis Streams 푸시
r.xadd(f'stream:{sid}', {'data': chunk, 'pts': pts}, maxlen=300)

# Kafka 파티션 키 = stream_id → 순서 보장
producer.produce('live-streams', key=sid.encode(), value=chunk)
flowchart LR
  P1[Producer 인제스트] -->|key=stream_A| K[(Kafka Topic<br/>partitions=100)]
  P2[Producer 인제스트] -->|key=stream_B| K
  K -->|partition 1| C1[Consumer 트랜스코더 1]
  K -->|partition 2| C2[Consumer 트랜스코더 2]
  K -->|partition N| CN[Consumer 트랜스코더 N]
같은 stream_id는 항상 같은 파티션 → 순서 보장.
15. HPA 비대칭 스케일링
| 스케일 업 | 스케일 다운 | |
|---|---|---|
| 안정화 윈도우 | 30초 | 600초 (10분) |
| 변화율 | +50% / 60초 | -10% / 300초 |
| 트리거 | GPU > 70% 또는 큐 지연 > 2s | GPU < 50% |
늘릴 땐 빨리, 줄일 땐 천천히 — 라이브 중인 방송 못 끔.
붉은 영역 = 폭증 대응 구간. 30초만에 50% 증가, 그러나 다운은 10분 걸쳐 천천히.
flowchart LR
  M1[메트릭<br/>GPU > 70%] --> HPA
  M2[메트릭<br/>큐 지연 > 2s] --> HPA
  HPA{HPA<br/>판단} -->|업| UP[+50% / 60s<br/>윈도우 30s]
  HPA -->|다운| DN[-10% / 300s<br/>윈도우 600s]
  UP --> SCALE[Pod replica 조정]
  DN --> SCALE
16. 예측 기반 스케일링 — 피크 5분 전 미리
flowchart LR
  H[과거 데이터<br/>같은 요일/시간] --> PRED[부하 예측 모델]
  T[최근 트렌드] --> PRED
  E[예정된 인기 방송] --> PRED
  PRED -->|5분 후 예측 부하| CMP{현재 capacity?}
  CMP -->|부족| EARLY[미리 스케일 업]
  CMP -->|충분| WAIT[유지]
18:00 피크 직격 시 반응형은 700ms rebuffering, 예측형은 100ms 이하.
17. 우선순위 QoS — 부하 폭증 시 누구부터
| Priority | 대상 | 부하 폭증 시 |
|---|---|---|
| P1 | Top 1% | 무조건 처리 |
| P2 | 광고/이벤트 진행 중 | 무조건 처리 |
| P3 | Top 10% | 정상 처리 |
| P4 | 일반 | 처리 |
| P5 | 베타 테스터 | 거부/지연 |
부하 95% 넘으면 P5부터 거부. 핵심 스트리머 보호.
18. Stream Migration — 방송 중 노드 이동
sequenceDiagram
  participant OLD as 노드 A (옛)
  participant NEW as 노드 B (새)
  participant PKG as 패키저
  participant V as 시청자

  Note over OLD,NEW: 1. 두 노드 동시 인코딩 시작
  OLD->>PKG: 출력 계속
  NEW->>PKG: 출력 시작 (워밍업 1~2초)
  Note over PKG: 2. 첫 GOP 경계 대기
  PKG->>V: 옛 노드 출력 (계속)
  Note over PKG: 3. GOP 경계 도달
  PKG->>V: 새 노드 출력으로 전환
  OLD->>OLD: 4. 종료
  Note over V: 5~10초 끊김 후 정상
Spot 인스턴스 회수 시 미리 알람 받아 graceful drain.
19. 월간 장애 빈도 — 실제 운영 데이터
가장 흔한 게 스트리머 측 변경. 인프라 장애가 아니라서 자동 복구 불가 — 알림만.
20. 장애 종류별 자동 복구 매핑
| 장애 | 감지 신호 | 자동 복구 | MTTR |
|---|---|---|---|
| GPU 드라이버 hang | nvidia-smi 타임아웃 | 3단계 복구 시퀀스 | 30~60s |
| FFmpeg 좀비 | 출력 mtime > 10s | 프로세스 kill + 재spawn | 5~15s |
| NVENC 세션 누수 | 세션 수 증가 모니터링 | FFmpeg 재시작 | 10s |
| SRT 패킷 손실 | 손실율 > 5% | SRT_LATENCY 증가 | 자동 |
| Kafka lag | consumer lag > 임계 | 컨슈머 추가 | 1~5분 |
| Region 장애 | 트랜스코딩 응답 90% 실패 | DNS 전환 또는 Active-Active | 5~10분 / 즉시 |
| CDN 장애 | 에러율 > 5% / p99 > 1s | GSLB 가중치 0 | 30s |
21. GPU Hang 3단계 자동 복구
flowchart TB
  D[nvidia-smi 5초 타임아웃 감지] --> S1[1단계: FFmpeg 프로세스 강제 kill<br/>NVENC 세션 정리]
  S1 --> CHK1{GPU 응답?}
  CHK1 -->|YES| OK[정상 복귀<br/>80% 케이스]
  CHK1 -->|NO| S2[2단계: nvidia-smi --gpu-reset<br/>드라이버 리셋]
  S2 --> CHK2{GPU 응답?}
  CHK2 -->|YES| OK2[정상 복귀<br/>95% 누적]
  CHK2 -->|NO| S3[3단계: 노드 재시작<br/>또는 노드 교체]
  S3 --> OK3[99% 누적 복구]
22. FFmpeg 좀비 감지
sequenceDiagram
  participant W as Watchdog
  participant FS as 파일시스템
  participant F as FFmpeg

  loop 5초마다
    W->>FS: stat $output/seg_*.m4s
    FS-->>W: 최신 mtime
    alt mtime < 10s
      Note over W: 정상
    else mtime >= 10s
      W->>F: SIGKILL
      W->>W: 새 FFmpeg spawn
      Note over W: 5~15s 끊김
    end
  end
CPU는 살아있는데 출력 안 나오는 좀비 상태 잡는 유일한 방법.
23. Discontinuity 자동 처리
flowchart LR
  D[스트림 중단 감지<br/>PTS 점프 또는 재시작] --> N[새 init.mp4 생성<br/>init_v(N+1).mp4]
  N --> M[매니페스트 갱신<br/>#EXT-X-DISCONTINUITY<br/>#EXT-X-MAP:URI=init_v(N+1).mp4]
  M --> S[시퀀스 +100 점프<br/>안전 마진]
  S --> P[플레이어 디코더 리셋<br/>~5초 끊김 후 정상]
코덱 설정 도중 바뀐 케이스도 같은 처리.
24. Region Active-Active
flowchart LR
  S[스트리머 OBS] -->|primary push| I1[서울 인제스트]
  S -->|backup push| I2[도쿄 인제스트]
  I1 --> T1[서울 트랜스코딩]
  I2 --> T2[도쿄 트랜스코딩]
  T1 --> SEL{출력 선택기}
  T2 --> SEL
  SEL -->|서울 정상| P[패키저<br/>서울 출력]
  SEL -.->|서울 죽음| P2[패키저<br/>도쿄 즉시 전환]
  P --> V[시청자]
  P2 --> V
| Active-Active | Passive Failover | |
|---|---|---|
| 비용 | 2배 | 1배 |
| 끊김 시간 | 0초 | 5~10분 (DNS TTL) |
| 적용 대상 | Top 1% 스트리머 | 일반 |
| 인제스트 송출 | OBS 두 번 송신 | 한 번만 |
25. Region Failover DNS 전환
flowchart LR
  D[Region 헬스체크<br/>트랜스코딩 90% 실패] --> DEC{Active-Active?}
  DEC -->|YES| AA[출력 선택기 즉시 전환<br/>0초 끊김]
  DEC -->|NO| DNS[DNS 라우팅 변경<br/>서울 → 도쿄]
  DNS --> NOT[활성 스트리머에게 알림<br/>reconnect URL]
  NOT --> CDN[CDN 캐시 무효화]
  CDN --> END[5~10분 끊김 후 정상]
26. CDN Failover GSLB 전환
sequenceDiagram
  participant V as 시청자
  participant B as 비콘 수집기
  participant G as GSLB
  participant A as Akamai
  participant CF as CloudFront

  V->>B: 재생 에러 비콘
  B->>G: 에러율 > 5% 보고
  G->>G: Akamai 가중치 100 → 0
  G->>G: CloudFront 가중치 0 → 100
  V->>G: 다음 DNS 쿼리
  G-->>V: CloudFront 엣지 IP
  V->>CF: 매니페스트 요청
  CF-->>V: 정상 응답
DNS TTL 30초로 짧게 → 빠른 전환.
27. 알람 P0/P1/P2 분류
| 레벨 | 대응 시간 | 예시 | 월 목표 빈도 |
|---|---|---|---|
| P0 | 5분 이내 호출 | 전체 인제스트 장애 / GPU 95% / CDN 장애 | 5건 이하 |
| P1 | 1시간 이내 | Region 트랜스코딩 노드 일부 / VMAF 회귀 / Rebuffering 2%+ | 20건 이하 |
| P2 | 업무 시간 | 비용 예산 80% / 디스크 85% / 인증 지연 | 무제한 (대시보드) |
P0 = 알람 피로 방지 핵심. 5건 초과면 룰 조정.
28. Chaos Engineering — 일부러 죽이기
| 기법 | 동작 | 검증하는 것 |
|---|---|---|
| Random Pod Kill | 무작위 K8s pod 종료 | HPA + Stream Migration |
| Network Partition | iptables로 일시 차단 | Region Failover |
| CPU Stress | 인위적 CPU 부하 | 스케줄러 회피 |
| GPU Throttle | NVIDIA 클럭 제한 | 헬스체크 + 자동 복구 |
| Latency Inject | 일시 패킷 지연 | SRT 재전송 + 버퍼 |
flowchart LR
  C[Chaos Monkey<br/>0.1% 확률] -->|매분 무작위| K[K8s Pod kill]
  C -->|0.01% 확률| N[Network partition 10s]
  C -->|매시간| S[CPU stress 60s]
  K --> R[자동 복구 시스템]
  N --> R
  S --> R
  R --> V{복구 성공?}
  V -->|YES| L[로그 기록]
  V -->|NO| A[Postmortem 작성]
비프로덕션에서 매일 굴림. 운영 환경엔 약하게.
29. Runbook as Code
# runbooks/gpu_hang.py
class GPUHangRunbook:
    description = "GPU 드라이버 hang 자동 복구"

    def check_trigger(self, alert):
        return alert.type == "gpu_unresponsive"

    def execute(self, alert):
        node = alert.affected_node
        if self.reset_gpu(node): return "RECOVERED"
        if self.reboot_node(node): return "RECOVERED"
        self.replace_node(node)
        return "RECOVERED_REPLACEMENT"
flowchart LR
  A[알람 발생] --> M[알람 매칭]
  M --> R[Runbook 검색]
  R -->|발견| EXE[자동 실행]
  R -.->|없음| H[사람 호출]
  EXE --> CHK{복구?}
  CHK -->|YES| L[로그 기록]
  CHK -->|NO| H
자동 복구가 우선, 사람 호출이 차선. 문서 대신 코드.
30. Postmortem 사이클
flowchart LR
  IN[장애 발생] --> RES[복구]
  RES --> WRITE[Postmortem 작성<br/>타임라인 + 근본 원인]
  WRITE --> REV[팀 리뷰]
  REV --> ACT[조치 항목<br/>코드 변경 / 알람 룰 / 자동화]
  ACT --> RUNBOOK[Runbook 갱신]
  RUNBOOK --> CODE[자동화 PR]
  CODE --> IN2[다음 장애 자동 처리]
같은 장애 두 번 안 나게. 작성 의무 + 액션 트래킹.
31. Pre-positioning — 인기 방송 캐시 워밍
flowchart LR
  P[예측: 5분 후 시작 + 예상 시청 > 10k] --> SEG[예상 첫 N개 세그먼트 식별]
  SEG --> EDGE[CDN 모든 엣지에<br/>가짜 요청 보내 캐시 채움]
  EDGE --> READY[Thundering Herd 방지]
  READY --> ORIGIN[Origin 부하 -90%]
방송 시작 직후 시청자 폭증 시 Origin 직격 막음.
32. Reserved + On-Demand + Spot — 시간축 분배
| 인스턴스 | 할인 | 중단 위험 | 용도 |
|---|---|---|---|
| Reserved (1년) | 80% | 없음 | 상시 부하 |
| On-Demand | 0% | 없음 | 평균 변동 |
| Spot | 90% | 있음 | 피크 분 |
전체 비용 30~40% 절감. Spot 회수 시 graceful drain.
33. CDN 비용 절감 Waterfall
$45K → $22.7K로 약 50% 절감. 누적 기법 효과.
34. CDN 단가 협상별 비교
| 등급 | GB 단가 | 월 트래픽 조건 |
|---|---|---|
| 소규모 약정 | $0.080 | < 10 TB |
| CloudFront 표준 | $0.050 | 일반 |
| 대량 협상 | $0.030 | > 1 PB |
| Akamai 대형 고객 | $0.020 | > 10 PB + 다년 |
협상력 = 트래픽 규모. Multi-CDN으로 경쟁시키면 추가 인하.
35. 코덱 라이센스 비용
AV1/VP9는 0 (AOMedia 오픈소스, Google). 라이브 플랫폼이 AV1 도입하는 큰 이유 중 하나.
36. Per-Title + 카테고리별 절감 효과
평균 30% 비트레이트 절감 → CDN + 트랜스코딩 동시 절감.
37. 채널당 단가 분포
이 단가가 매일 추적하는 핵심 지표. 갑자기 튀면 누가 잘못 설정한 것.
38. A/B 테스트 — 가상의 비용·매출 비교 예시
실제 수행한 A/B 테스트가 아니다. 아래 숫자는 계산 구조를 설명하려고 가정한 입력이며, 표본·분산·신뢰구간을 갖춘 결과가 아니다.
| 지표 | A: 표준 (6000k) | B: 절감 (4500k) |
|---|---|---|
| 평균 시청 시간 | 38분 | 37분 (-3%) |
| Rebuffering | 0.4% | 0.6% (+0.2%p) |
| 채널당 비용 | $0.12/시간 | $0.09/시간 (-25%) |
| 추정 매출 | $0.95 | $0.93 (-2%) |
| 마진 | $0.83 | $0.84 (+1%) |
마진 1% 우위 → B 도입. 시청 시간 감소가 비용 절감보다 작을 때만 절감 정당.
flowchart TB
  AB[A/B 2주 측정] --> D{시청시간 영향?}
  D -->|증가| ADOPT[즉시 도입]
  D -->|감소| DELTA{매출 감소 < 비용 절감?}
  DELTA -->|YES| ADOPT
  DELTA -->|NO| REJECT[적용 안 함]
39. 캐시 TTL 권장값
| 자원 | TTL | 이유 |
|---|---|---|
| 세그먼트 (.m4s) | 24시간 | 한 번 생성 후 안 변함 |
| 라이브 매니페스트 | 1~2초 | 6초마다 변함 |
| VOD 매니페스트 | 30분 | 변할 일 거의 없음 |
| init.mp4 | 24시간 | 코덱 설정 안 바뀌면 고정 |
40. FinOps 3단계
flowchart LR
  I[Inform<br/>비용 가시화] --> O[Optimize<br/>Reserved/Spot, 라이트사이징]
  O --> P[Operate<br/>예산 알람, 변경 승인]
  P --> I

  style I fill:#e0f2fe
  style O fill:#dcfce7
  style P fill:#fef3c7
| 단계 | 활동 | KPI |
|---|---|---|
| Inform | 팀별/서비스별 비용 분배 | 채널당 단가 가시화 |
| Optimize | 인스턴스 라이트사이징, Reserved/Spot | 월 비용 -20% |
| Operate | 예산 자동 알람, 변경 승인 | 예산 초과 0건 |
41. 비용 거버넌스 승인 흐름
flowchart TB
  PR[설정 변경 PR] --> EST[자동 비용 영향 추정]
  EST --> D{월 영향?}
  D -->|< $1K| AUTO[엔지니어 자율]
  D -->|$1K ~ $10K| LEAD[팀 리드 승인]
  D -->|> $10K| DIR[디렉터 승인]
  AUTO --> MERGE[Merge]
  LEAD --> MERGE
  DIR --> MERGE
  MERGE --> TRACK[월 비용 추적]
설정 변경 PR마다 비용 영향 자동 첨부. 예산 책임 분산.
정리하면
라이브 트랜스코딩 인프라는 7층 마이크로서비스 + 자동 복구 + 비용 최적화의 종합 운영이다.
- 7층 분리가 정석 — 자원 패턴 달라 각 인스턴스 타입 맞춤
- 방송 시작 시간 — 본문의 6.2초는 설명용 입력이며 측정값이 아니다
- CDN 45% + 트랜스코딩 25% = 비용 70% → 절감 우선순위
- A10이 가성비 정점 — T4 대비 처리량 2배, 가격 1.9배
- Bin Packing으로 빈 노드 종료 → 30~40% 절감
- Tier Scheduling — Top 1%만 Premium GPU, 일반은 Budget
- 큐 선택: SRT (소규모) / Redis Streams (중규모) / Kafka (대규모)
- HPA 비대칭: 업 30초, 다운 10분 — 라이브 방송 보호
- 예측 + HPA 결합으로 피크 5분 전 미리 확장
- 우선순위 QoS — 부하 폭증 시 P5부터 거부
- Stream Migration으로 GOP 경계에서 노드 이동 (5~10초 끊김)
- 장애 자동 복구 = Runbook as Code — 사람 호출은 차선
- GPU 3단계 복구: kill → reset → reboot (99% 자동 복구)
- FFmpeg 좀비 = 출력 mtime 헬스체크 — 유일한 방법
- Region Active-Active = Top 1%만 (0초 끊김), 일반은 Passive (5~10분)
- Multi-CDN GSLB — CDN 한 곳 장애 시 30초 내 가중치 전환
- P0 알람 월 5건 이하 — 더 많으면 룰 조정
- Chaos Engineering + Postmortem 사이클로 같은 장애 반복 방지
- Pre-positioning으로 Thundering Herd 차단
- Reserved 50% + On-Demand 30% + Spot 20% = 비용 30~40% 절감
- Origin Shield — 요청 hit rate와 Origin 전송 바이트를 구분해 측정한다
- 카테고리별 사다리 = 30% 비트 절감 → CDN + 트랜스코딩 동시
- AV1/VP9 라이센스 0 — H.264 대비 $250K/년 절감 (디바이스 보급 따라 점진)
- A/B 테스트로 비용 절감의 매출 영향 검증 — 마진 기준 결정
- TTL 분리: 세그먼트 24h, 매니페스트 1~2s
- FinOps 3단계 — Inform → Optimize → Operate
- 비용 거버넌스: PR마다 영향 추정, $1K/$10K 단계별 승인
이 글로 레벨 4 (트랜스코딩과 인프라) 정리 종료. 다음 글에선 CDN 멀티 벤더 / Origin Shield / 글로벌 전송 깊이 또는 WebRTC 기반 인터랙티브 라이브로 넘어간다.
참고
대기 시간은 어디에 쌓일까?
아래 결과는 선택한 입력으로 계산합니다. 실제 서버에 요청하거나 본문의 실험을 재실행하지 않습니다.
- 인코딩
- 0.30초
- 전송
- 0.20초
- 세그먼트 대기
- 1.00초
- 버퍼
- 4.00초
모형의 대기 예산: 5.50초
계산식: 인코딩 + 전송 + 세그먼트 길이 ÷ 2 + 길이 × 추가 버퍼 개수. 도착 시점이 균일하고 각 대기를 순서대로 더한다는 가정입니다. 실제 HLS 지연의 예측치가 아니며, 단계의 중첩·지터·플레이어 정책·LL-HLS의 부분 세그먼트는 포함하지 않습니다.