약 4초마다 생기는 녹화 파일에서 영상 1개와 대표 오디오 1개를 남기려고 매번 FFmpeg 프로세스를 시작하고 종료했습니다. 필요한 작업은 재인코딩이 아니라 압축 샘플을 보존한 채 트랙과 시간을 재구성하는 재포장이었습니다. 저는 이 반복 작업을 상주 Go 프로세스의 함수 호출로 옮겼습니다.
같은 입력에서 읽기·재포장·로컬 쓰기를 모두 포함해 각 200회 측정한 p50은 23.43ms → 3.05ms, 7.69배 차이였습니다. 그런데 첫 실험의 “10.9배”와는 다른 숫자였습니다. 최초 Go 측정에서 빠진 I/O를 포함해 비교 범위를 맞췄기 때문입니다.
구현과 계측은 AI와 협업했습니다. 제가 내린 판단은 반복 프로세스 호출을 없애는 실행 단위 변경과, 그 효과를 설명할 수 있도록 두 경로의 측정 범위를 다시 맞추는 것이었습니다. 아래 결과는 재포장 경로의 값이며 전체 서비스 지연은 별도입니다.
범용 변환기에서 필요한 재포장만 가져오기
Go 재포장기는 녹화기와 같은 계열의 mediacommon/v2를 사용해 필요한 트랙과 파트를 보존합니다. 첫 영상·첫 오디오를 선택하고, init과 미디어 조각을 반환합니다. mtxi와 회차 보정값으로 시간 위치를 계산하며, 전체 입력을 읽는 구조에는 16MiB 상한을 둡니다. 범용 변환기를 호출하는 대신 Producer의 경계 안에서 필요한 규칙을 통제한 것입니다.
이 선택은 프로세스 기동을 없애는 대신 init·시간축 규칙과 메모리 사용을 서비스 안으로 가져왔습니다. 따라서 속도만 보고 교체할 수는 없었습니다. 입력 트랙에서 같은 init이 만들어지는지, 시간 경계가 유지되는지, 라이브러리 버전 변경에도 출력이 같은지를 따로 확인했습니다. 이 생산 경계는 PR #192에 포함됐습니다.
과거 10.9배와 현재 7.69배를 섞지 않았습니다
과거 10분 실험은 1280×720, 30fps, H.264 B-frame 2, 오디오 6개였습니다. 4분 송출–3초 끊김–4분 송출–8초 끊김–2분 송출로 150조각, 약 340MB를 만들었습니다. p50은 FFmpeg 18.70ms, Go 1.72ms였습니다. 이때 p95는 19.9→2.36ms, 최대는 51.3→7.15ms였습니다.
하지만 Go 수치에서 파일 읽기·쓰기가 빠져 있었습니다. FFmpeg는 프로세스를 시작해 파일을 읽고 결과를 쓰는 동안, Go는 더 좁은 구간만 잰 것입니다. 이대로 10.9배를 대표값으로 삼으면 실행 단위를 바꾼 효과와 계측 범위를 줄인 효과가 섞입니다. 그래서 과거 값을 보존하되, 양쪽에 읽기와 로컬 쓰기를 넣은 대조를 새 대표 결과로 삼았습니다.
| 측정 | FFmpeg p50 | Go p50 | 비교 범위 |
|---|---|---|---|
| 과거 150조각 | 18.70ms | 1.72ms | Go I/O 제외, 조건 비대칭 |
| 동일 I/O, 각 200회 | 23.43ms | 3.05ms | 양쪽 읽기·재포장·로컬 쓰기 포함 |
같은 5,155,160B 파일을 200번씩 처리했습니다
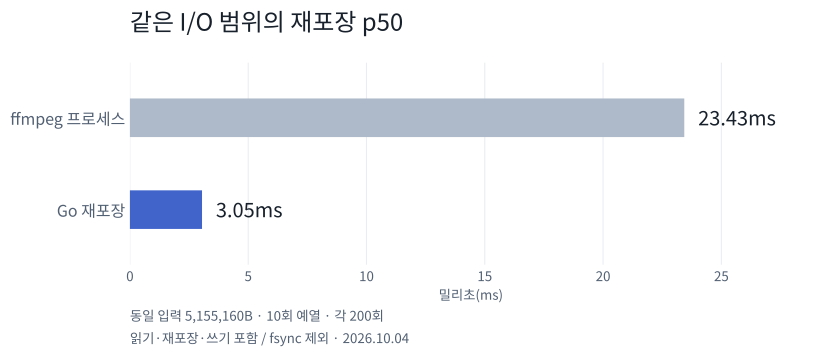
재측정은 2026년 10월 4일 macOS arm64, Go 1.26.5, FFmpeg 8.1.2에서 진행했습니다. 입력은 1920×1080·30fps·B-frame 2·AAC 오디오 6개인 합성 4초 파일이며 실제 컨테이너 길이는 4.066667초, 크기는 5,155,160B입니다. 같은 파일을 10회 예열한 뒤 각 200회 처리했습니다.
| 동일 I/O 측정 | FFmpeg | Go |
|---|---|---|
| p50 | 23.43ms | 3.05ms |
| p95 | 24.50ms | 3.29ms |
| 산출 트랙 | 영상 1개·오디오 1개 | 영상 1개·오디오 1개 |
| 산출 길이 | 4.066667초 | 4.066667초 |
7.69배는 반올림 전 23.4330625 ÷ 3.0479995 = 7.688…로 계산했습니다. Go는 상주 프로세스이고 FFmpeg는 매번 시작한다는 실제 구조 차이는 유지했습니다. warm file cache 조건이며 fsync·S3·네트워크·동시 방송은 제외했습니다. 입력 해시와 각 200행 CSV, summary를 보존했고 전체본 13쪽에 조건을 함께 표시했습니다.
CPU 프로파일도 별도 실행으로 남겼습니다. 약 0.8초 샘플에는 파일 I/O와 런타임 비용이 섞여 있어 함수별 운영 비율을 정하기에는 짧았습니다. 따라서 속도 차이의 대표 근거는 같은 범위의 200회 대조에 두고, 프로파일은 추가 분석 자료로 구분했습니다.
처리량이 그대로인데 메모리만 늘 수도 있었습니다
10월 6일에는 실제 녹화 입력 3종, 동시성 1·2·4·8, 독립 프로세스 5회, 프로세스당 800회로 48,000회를 검사했습니다. Apple M5, Go 1.26.5, GOMAXPROCS=4, 디스크·S3 제외 조건이며 모든 출력 SHA256이 기대값과 같았습니다.
| 6.78MB 입력 동시 작업 | 최대 RSS 중앙값 | 호출 p95 중앙값 |
|---|---|---|
| 1 | 85MiB | 5.83ms |
| 2 | 107MiB | 10.57ms |
| 4 | 172MiB | 11.15ms |
| 8 | 303MiB | 45.21ms |
동시 작업을 4→8로 늘렸을 때 처리량은 약 293→294회/초였지만 RSS는 172→303MiB, 호출 p95는 11.15→45.21ms가 됐습니다. 이 조건에서는 작업 수를 더 늘릴 이득보다 메모리와 긴 응답의 비용이 컸습니다. 단일 호출이 빨라진 다음에도 동시 작업 수 제한이 필요한 근거였습니다.
여기서 p95는 실행별 p95의 중앙값입니다. 누적 할당 36.90MB/호출과 최대 RSS도 서로 다른 지표입니다. 동시성 결과는 10월 4일의 동일 I/O 대조와 달리 디스크·S3를 제외했으므로 두 표의 시간을 한 전후 비교로 합치지 않습니다.
속도와 재생 정합성은 다른 증거가 필요했습니다
과거 150조각에서는 init 해시가 1종이었고, 같은 녹화기 구간의 147개 경계에서 영상 ±1 tick·오디오 ±1 sample을 대조했습니다. 첫 오디오 220Hz 유지와 당시 라이브러리 v2.9.3·v2.9.4의 출력 바이트 일치도 확인했습니다. 이는 새 200회 속도 시험과 다른 검증입니다.
필요한 재포장만 상주 프로세스에 가져오자 같은 I/O 범위의 p50이 23.43→3.05ms로 줄었습니다. 대신 입력 전체를 읽는 메모리 비용과 직접 유지할 시간축 규칙이 생겼습니다. 그래서 교체의 효과와 비용을 200회 속도 대조, 과거 150조각의 출력·재생 경계, 별도 48,000회 동시성 시험으로 나눠 확인했습니다. 더 빠른 함수로 바꾸는 일과 그 함수를 안전하게 여러 번 실행하는 일은 각각 근거가 필요했습니다.
이 글은 PokeClip의 개발·검증 기록을 2026년 10월 15일 기준으로 정리한 CASE 24입니다. 전체 기술 기록에서 연결되는 결정을 함께 읽을 수 있습니다.